Das Neuron und das Perzeptron
Das McCulloch-Pitts-Neuron
Das Modell von 1943 ist von der Biologie inspiriert: Ein Neuron bekommt über Dendriten Signale von anderen Neuronen, summiert sie gewichtet auf und „feuert“, wenn die Summe eine Schwelle überschreitet. Als Formel: Mit Gewichten ist die Aktivierung
und die Ausgabe
für eine nichtlineare Aktivierungsfunktion . Bei McCulloch und Pitts ist eine Schwellenwertfunktion, die 0 oder 1 ausgibt; später wird die logistische Sigmoidfunktion sein oder ReLU. Diese Rollenverteilung gilt im ganzen Buch: ist eine beliebige Aktivierungsfunktion, immer die logistische Sigmoidfunktion. Die Struktur „Skalarprodukt, gefolgt von einer nichtlinearen Funktion“ ist das Kochrezept, das uns durch die gesamte Vorlesung begleiten wird.
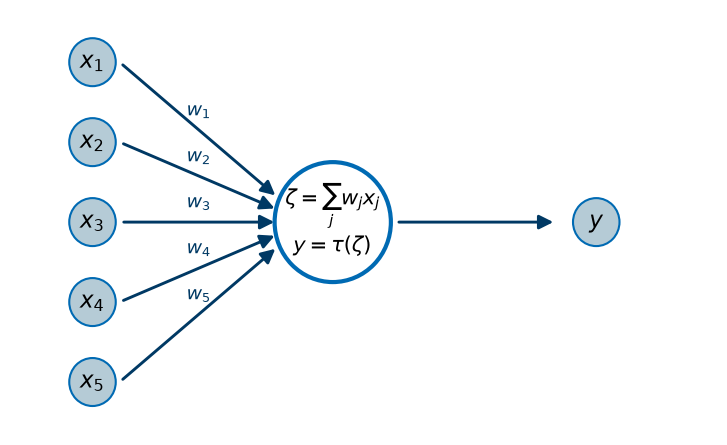
Das McCulloch-Pitts-Neuron: gewichtete Summe der Eingaben, dann eine nichtlineare Aktivierungsfunktion.
Das Perzeptron
Rosenblatts Beitrag war weniger das Neuron als der Lernalgorithmus dafür. Das Perzeptron ist ein Modell zur binären Klassifikation: Input sind Stichproben von mit und . Die Parameter des Modells sind ein Gewichtsvektor und ein Biasterm . Die Inferenz ist
wobei die Iverson-Klammer ist: , wenn die Aussage wahr ist, sonst 0. Das Perzeptron ist also ein McCulloch-Pitts-Neuron mit der Schwellenwertfunktion . Man beachte: ist eine nichtlineare Funktion, obwohl im Inneren nur ein Skalarprodukt steht.
Den Bias kann man loswerden, indem man ihn als nulltes Gewicht auffasst: Mit und ist . Das ist ein Trick, den wir noch öfter sehen werden. Umgekehrt heißt das: Ein Perzeptron ohne Bias kann nur Hyperebenen durch den Ursprung lernen – zwei Klassen, die sich nur mit einer verschobenen Geraden trennen lassen, bleiben ihm verschlossen.
Geometrisch beschreibt die Gleichung eine Hyperebene in (in : eine Gerade), und gibt an, auf welcher Seite von der Punkt liegt. Der Vektor steht senkrecht auf : Für zwei Punkte ist
also ist orthogonal zu jeder Richtung innerhalb von .
Mehr noch: Die Aktivierung misst, wie weit von entfernt ist. Sei der normierte Normalenvektor. Jeder Punkt lässt sich zerlegen als mit einem Punkt (dem Lotfußpunkt) und einer Zahl . Dann ist
Das ist der vorzeichenbehaftete Abstand von zur Hyperebene: positiv auf der Seite, in die zeigt, negativ auf der anderen, null auf . Die Aktivierung eines Neurons ist nichts anderes als dieser Abstand, multipliziert mit .
Daraus folgt eine Beobachtung, die uns bei der logistischen Regression wieder begegnen wird. Multipliziert man und mit derselben Zahl , so ändert sich weder noch die Entscheidung , aber die Aktivierung wird um den Faktor skaliert. Die Richtung von legt fest, was klassifiziert wird; die Länge von legt fest, wie schnell die Aktivierung mit dem Abstand wächst. Für das Perzeptron ist die Länge egal. Sobald wir statt der Sprungfunktion eine glatte Aktivierungsfunktion verwenden, ist sie es nicht mehr: Für die logistische Sigmoidfunktion ist bei praktisch 1, bei nur knapp über . Dieselbe Trenngerade, ganz andere „Sicherheit“.
Ein Perzeptron kann also genau die Klassifikationsprobleme lösen, bei denen die beiden Klassen linear trennbar sind – nicht mehr. Das berühmte Gegenbeispiel ist XOR: Die Punkte und lassen sich nicht durch eine Gerade von und trennen. Das ist die mathematische Substanz hinter dem AI Winter – und der Grund, warum wir mehrere Neuronen hintereinander schalten werden.
Wie das Perzeptron trainiert wird, also wie und aus den Daten bestimmt werden, ist Thema des nächsten Kapitels; auf einem Übungsblatt implementieren Sie es dann selbst.
Was ist ein neuronales Netz?
Ein Multilayer Perceptron (MLP) entsteht, indem die Ausgaben von mehreren (verallgemeinerten) Perzeptrons als Eingabe für ein weiteres Perzeptron verwendet werden, welches also eine Schicht (Layer) weiter hinten ist.
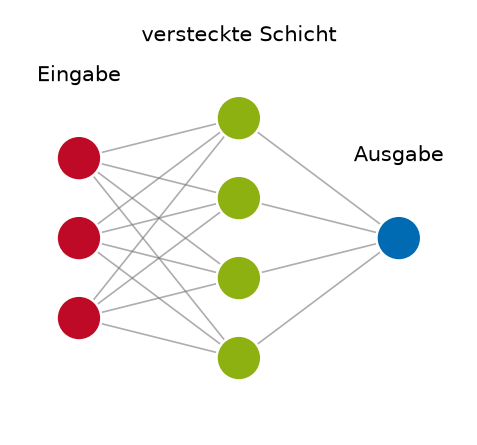
Ein Multilayer Perceptron mit 3 Eingaben, einer versteckten Schicht aus 4 Neuronen und einem Ausgabeneuron. Jeder Pfeil ist ein Gewicht.
Formal: Eine Schicht mit Neuronen, die alle dieselben Eingaben bekommen, hat eine Gewichtsmatrix und einen Biasvektor und berechnet
wobei komponentenweise angewendet wird.
Wie liest man ? Die -te Komponente von ist das Skalarprodukt der -ten Zeile von mit . Die Zeilen von (in NumPy W[i, :]) sind also die Gewichtsvektoren der Neuronen, und berechnet Aktivierungen auf einmal, mit dem vorigen Abschnitt: skalierte Abstände zu Hyperebenen. Als Bild in : Jedes Neuron der ersten Schicht zeichnet eine Gerade in die Eingabeebene, und der Vektor sagt für jede dieser Geraden, auf welcher Seite liegt und wie weit weg. Das XOR-Beispiel unten ist genau das: zwei Geraden, dann eine Entscheidung im Raum der beiden Seiten-Informationen.
In PyTorch speichert nn.Linear(n, m) die Matrix als weight mit Shape (m, n), eine Zeile pro Neuron, und bias mit Shape (m,).
Ein Netz mit Schichten berechnet dann
Dabei können die Schichten verschieden groß sein, manche Einträge von können 0 sein (fehlende Pfeile), es kann Pfeile rückwärts geben (rekurrente Netze), und es können viele verschiedene nichtlineare Funktionen vorkommen (ReLU, Convolution, Softmax, …). Die Gesamtheit der Einträge aller und sind die Parameter oder Gewichte des Netzes; bei modernen Modellen sind das Milliarden von Zahlen. „Deep“ heißt: ist groß.
Warum das Hintereinanderschalten hilft, sehen wir am XOR-Problem: Mit zwei Perzeptrons in der ersten Schicht, die „“ und „“ berechnen, und einem dritten Perzeptron, das deren Ausgaben mit UND verknüpft, ist XOR plötzlich linear trennbar – im Raum der Ausgaben der ersten Schicht.
Übung
Sei und , also das Perzeptron .
Berechnen Sie für , und jeweils die Aktivierung und den vorzeichenbehafteten Abstand zur Geraden. Tipp: Der Abstand ist die Aktivierung geteilt durch , und .
Ersetzen Sie durch und durch . Was ändert sich an der Geraden, was an den Aktivierungen, was an den Abständen?
Antwortprobe: Genau eine der drei Größen ändert sich.