Was ist eigentlich Deep Learning?
Der Name ist erfreulich ehrlich: Deep heißt „viele Ebenen (Layer)“, Learning heißt „Training“. Deep Learning ist also das Training von künstlichen neuronalen Netzen mit vielen Ebenen. Was ein künstliches neuronales Netz ist, was eine Ebene ist und was beim Training passiert, ist der Inhalt dieser Vorlesung. Am Ende des Kapitels haben wir zumindest eine erste Definition.
Was Sie mitbringen sollten
Wir setzen voraus, dass Sie die folgenden Begriffe schon einmal gesehen haben und keine Angst vor ihnen haben: Vektorraum und Vektor, Matrix, Ableitung, Zufallsvariable, und eine grobe Idee davon, was lineare Regression ist. Dazu Grundlagen in Python, idealerweise mit NumPy. Am besten hat man vorher das Modul „Data Science“ bestanden; die Module „Machine Learning“ oder „Data Science 2“ sind nicht erforderlich.
Was wir zusammen lernen
Begriffe wie Gradientenabstieg, Loss-Funktion, Matrizen- und Tensorkalkül, latenter Raum, logistische Regression. Die Grundlagen von PyTorch. Was ein neuronales Netz ist, wie man fertige Modelle benutzt, wie man fertige Modelle verändert, und was die Besonderheiten bei Text und bei Bildern sind.
Der grobe Plan in Stichworten: Geschichte (Perzeptron) – Hugging Face (fertige Modelle) – PyTorch (eigene Modelle) – logistische Regression (Softmax) – Gradientenabstieg und Backpropagation – Sparse Autoencoder und VAE für die Klassifikation von MNIST-Ziffern – NLP mit word2vec und Tokenizern – CNNs für MNIST – LLMs benutzen – GANs (wie DALL-E mini).
Wieso Python eine Katastrophe ist
Für maschinelles Lernen ist Python eigentlich völlig ungeeignet, denn es ist
single-threaded by default, mit Garbage Collection und GIL (global interpreter lock), was Multithreading eher erschwert als erleichtert;
interpretiert, nicht direkt auf die Maschine kompiliert, und daher etwas langsam;
dynamisch typisiert, d.h. Typen sind erst zur Laufzeit bekannt, daher aufwändiges Typechecking;
nicht maschinennah, daher ist es schwierig, SIMD-Register und Cachegrößen der spezifischen Hardware zur Optimierung zu nutzen.
Wieso Python ganz toll ist
Für maschinelles Lernen ist Python perfekt, weil
Rapid Prototyping im schnelllebigen ML-Geschäft erforderlich ist;
die schwierigen Rechnungen in C, Rust oder CUDA durchgeführt werden und Python nur die Funktionsaufrufe macht;
die Sprache sehr populär ist und damit viele gut gewartete Pakete das Datenhandling sehr leicht machen;
man damit alle Prinzipien schnell lernen kann, die man später immer noch in anderen Sprachen implementieren könnte;
damit trainierte Modelle (die Gewichte) unabhängig von Python zur Inferenz verwendet werden können.
Der scheinbare Widerspruch löst sich auf, wenn man Python als Steuersprache betrachtet: Die eigentliche Arbeit – Matrixmultiplikationen auf Millionen von Zahlen – passiert in kompiliertem Code, oft auf der GPU. Python sagt nur, welche Operation als Nächstes dran ist. Genau das ist die Idee der vektorisierten Programmierung mit NumPy, und PyTorch treibt sie weiter.
Antworten zum Lesetext
GPU und SIMD. SIMD (single instruction, multiple data) ist ein Rechenprinzip: dieselbe Operation gleichzeitig auf vielen Datenelementen. Eine GPU ist ein Produkt, das dieses Prinzip mit tausenden kleinen Rechenkernen umsetzt, ursprünglich für die parallele Berechnung von Bildpunkten. Für Deep Learning zählt nur das Prinzip, denn Matrixmultiplikation ist SIMD-Arbeit. Deshalb eignet sich eine Gaming-Grafikkarte zum Trainieren, und deshalb sind die Chips in Rechenzentren, die nie ein Bild ausgeben, streng genommen keine Graphics Processing Units mehr.
PyTorch wurde bei Facebook AI Research entwickelt (heute Meta) und wird seit 2022 unter dem Dach der Linux Foundation als PyTorch Foundation weiterentwickelt; Meta bleibt der größte Beitragende. TensorFlow, die Konkurrenz von Google, hat an Bedeutung verloren.
CUDA und ROCm sind die Software-Plattformen (Compiler, Bibliotheken, Treiber), mit denen man SIMD-Programme auf NVIDIA- bzw. AMD-Hardware schreibt und ausführt. CUDA ist proprietär und seit 2007 der De-facto-Standard, auf dem PyTorch und fast alle Forschungscodes aufsetzen. ROCm ist AMDs quelloffenes Gegenstück; die Schicht HIP bildet die CUDA-Schnittstelle nach, aber ROCm kam später und hat weniger fertige Bibliotheken. Genau das ist der moat aus dem Titel: nicht die Hardware, sondern die Software drumherum. Wir programmieren in dieser Vorlesung weder CUDA noch ROCm, sondern PyTorch, das beides als Backend benutzen kann.
Erinnerung: Begriffe aus dem maschinellen Lernen
Daten und erzeugende Verteilung
Wir haben Datenpunkte mit jeweils . Die Grundannahme des maschinellen Lernens ist, dass es eine erzeugende Verteilung (die Population) einer Zufallsvariable gibt, aus der die Datenpunkte als Stichprobe gezogen wurden – und die wir nicht kennen.
Ein Modell für ist eine Beschreibung dieser Verteilung, etwa durch eine Dichtefunktion oder durch einen Sampler, also einen Algorithmus, der neue Stichproben erzeugt. Ein solches Modell heißt generativ, weil man damit Stichproben generieren kann. Ein klassisches Beispiel ist ein Gaussian Mixture Model, mit dem man etwa ein Bild in Vorder- und Hintergrund segmentieren kann.
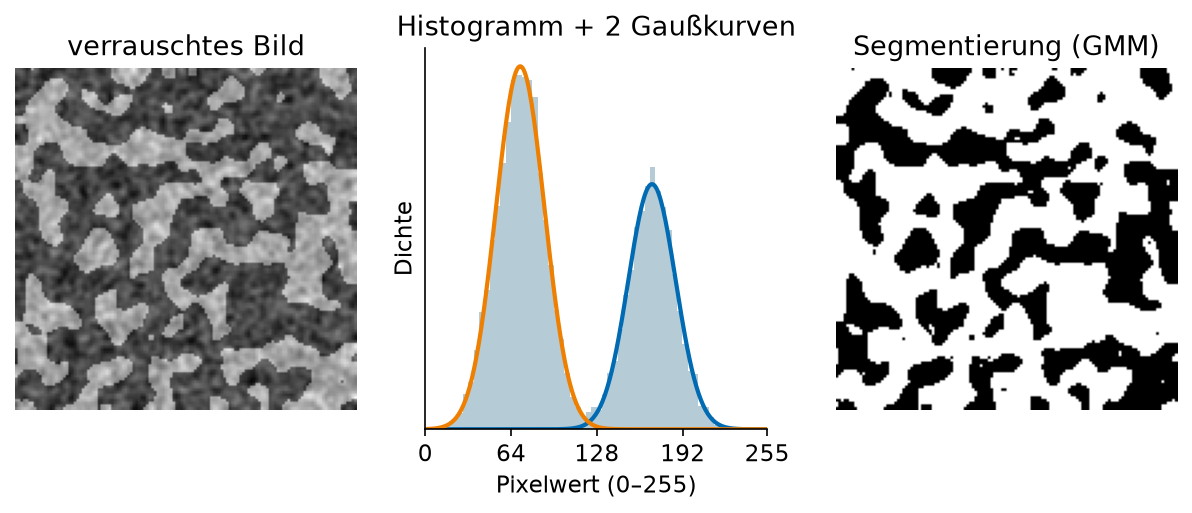
Ein generatives Modell in Aktion: Ein Gaussian Mixture Model mit zwei Komponenten wird an das Histogramm der Pixelwerte gefittet und trennt so Vorder- und Hintergrund (nach einem Beispiel aus den Scipy Lectures).
Supervised und Unsupervised
Wenn es zu den Datenpunkten auch (bekannte) Label gibt, d.h. nicht nur , sondern auch mit , so sprechen wir von Supervised Learning. Oft ist (einfache Regression) oder sogar (binäre Klassifikation). Ohne Label ist es Unsupervised Learning; dazu gehören generative Modelle wie oben, aber auch Clustering und Dimensionsreduktion.
In beiden Fällen unterscheiden wir zwei Phasen:
Training: Input sind die Daten, Output ist ein gefittetes Modell (bei uns: ein Satz Zahlen, die Gewichte).
Inferenz: Input sind neue Daten und das gefittete Modell, Output ist die Vorhersage.
Regression und Klassifikation
Regression ist supervised, d.h. es gibt -Paare. Das Ziel ist ein funktionaler Zusammenhang
sodass für die Stichprobe der Fehler möglichst klein ausfällt. Bei der linearen Regression ist affin-linear, .
Klassifikation ist der Spezialfall, in dem nur endlich viele Werte annimmt, z.B. . Man kann Klassifikation als Regression betreiben – man fittet mit reellen Werten und färbt anschließend nach – aber wir werden sehen, dass das nicht die beste Idee ist und die logistische Regression es besser macht.
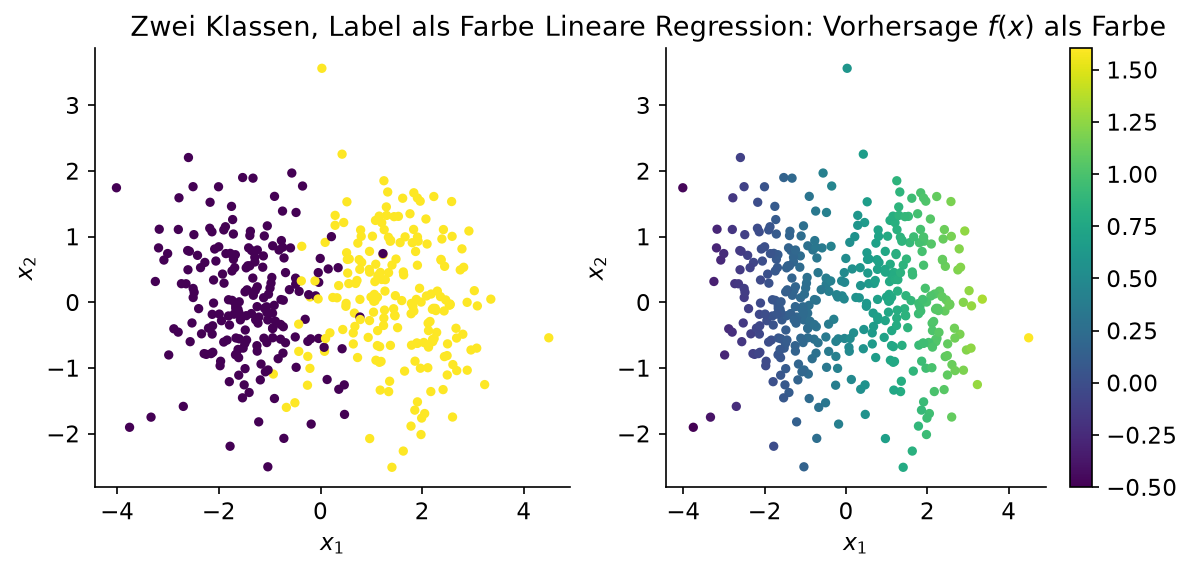
Zwei linear trennbare Klassen (links) und eine lineare Regression mit der Klasse als abhängiger Variable (rechts): Die Vorhersage ist eine reelle Zahl, die man bei abschneiden kann.
Die Kernfrage: Wie gut ist das Modell?
Wie bewerte ich die Güte des Modells, wie bewerte ich den Erfolg der Inferenz? Die Standardantwort ist der Training-Test-Split: Man hält einen Teil der Datenpunkte zurück (verwendet ihn nicht im Training), um damit das trainierte Modell zu testen. Die kompliziertere Variante ist die -fold cross validation, bei der man die Daten in Teile zerlegt und reihum jeden Teil einmal als Testset verwendet.
Und was misst man auf dem Testset? Bei Klassifikation naheliegend die Accuracy, den Anteil korrekt klassifizierter Samples. Die ist irreführend, wenn die Klassen unbalanciert sind (99 % Nicht-Spam: ein Modell, das immer „kein Spam“ sagt, hat 99 % Accuracy). Dann schaut man pro Klasse auf Precision (welcher Anteil der als positiv vorhergesagten Samples ist wirklich positiv?) und Recall (welcher Anteil der wirklich positiven Samples wurde gefunden?); bei Regression auf den mittleren quadratischen Fehler. Wir kommen bei den Loss-Funktionen darauf zurück.
Antwort: Wer Modelle vergleicht und Hyperparameter nach dem Testergebnis wählt, lässt das Testset indirekt ins Modell einfließen – die gemessene Güte ist dann zu optimistisch. Deshalb spaltet man vom Trainingsset ein Validation-Set ab (Validation-Split), trifft daran alle Entscheidungen und fasst das Testset genau einmal an, ganz am Ende.
Kurzgeschichte
Bis 2010
1943: McCulloch und Pitts modellieren ein menschliches Hirnneuron mit elektrischen Schaltkreisen.
1958: Rosenblatt entwirft das Perzeptron – und es wurde tatsächlich gebaut: Der Mark I Perceptron am Cornell Aeronautical Laboratory war ein frühes System zur Mustererkennung, mit Fotozellen als Eingabe und Potentiometern als Gewichten, die von Elektromotoren nachgestellt wurden.
Das Perzeptron kann nur linear trennbare Klassen unterscheiden lernen (dazu gleich mehr). Diese Einsicht, prominent im Buch Perceptrons von Minsky und Papert (1969), gilt als Auslöser des ersten AI Winter. Wie viel an dieser offiziellen Geschichte dran ist, untersucht lesenswert: Olazaran, M. (1996). A Sociological Study of the Official History of the Perceptrons Controversy. Social Studies of Science, 26(3), 611–659.
1986: Backpropagation wird (wieder-)erfunden bzw. populär, mehr Schichten werden verwendet.
2010–2015
Lesetipp: „The Decade of Deep Learning“ von Leo Gao, bmk
2012 AlexNet – „the paper that sparked the field of Deep Learning“: ein CNN gewinnt die ImageNet-Challenge mit großem Abstand, trainiert auf GPUs.
2013 word2vec – Repräsentation von Wörtern als Vektoren in einem latenten Raum.
2014 GANs – erstmals „realistische“ Bildgenerierung.
Nach 2015
Das meiste davon ist Stoff der aufbauenden Module. Die Transformer sind die Ausnahme:
2017 Transformer, „Attention is all you need“ – die Grundlage für GPT. Die sehen wir uns im Kapitel „Transformer“ an und benutzen sie im Kapitel „LLMs benutzen“ – trainieren werden wir aber keine.
2020 AlphaFold 2 „löst“ das Proteinfaltungsproblem – Nobelpreis für Chemie 2024.
2021 Diffusionsmodelle schlagen GANs bei der Bildgenerierung (Dhariwal und Nichol, Diffusion Models Beat GANs on Image Synthesis); das Verfahren selbst, DDPM, ist von 2020.
2022 Veröffentlichung von ChatGPT; danach RLHF, Copilot, Multimodalität, RAG, Agents, …
2024/25 Agentic Coding: Modelle bearbeiten echte GitHub-Issues selbstständig – Code lesen, ändern, Tests laufen lassen, nachbessern. Gemessen wird das auf SWE-bench Verified, 500 von Menschen geprüften Aufgaben aus zwölf Python-Projekten; bestanden ist eine Aufgabe erst, wenn die Tests des Projekts durchlaufen. Innerhalb von zwei Jahren ging das von wenigen Prozent auf über die Hälfte.
Diese Prozentzahlen sind die unzuverlässigsten in diesem Kapitel, und zwar aus einem Grund, der über den Benchmark hinausgeht: Ein Modell wird hier nie allein gemessen, sondern immer zusammen mit seinem Harness. Das Harness ist das Programm drumherum – es entscheidet, welche Dateien das Modell zu sehen bekommt, welche Werkzeuge es aufrufen darf, was passiert, wenn ein Test fehlschlägt und was aus dem Verlauf weggeworfen wird, wenn der Kontext voll ist. Lewis (2026, Same Model, Different Harness: Different Coding-Agent Results) hält die Gewichte fest und ändert nur, wie das Harness ältere Werkzeugausgaben kürzt: Der Anteil reparierter Tests steigt von 28 % auf 49 %. Einundzwanzig Prozentpunkte, ohne dass am Modell etwas geändert wurde.
Daraus folgen zwei Dinge. Erstens ist die Frage „welches Modell ist besser?“ in dieser Disziplin schlecht gestellt – gemessen wird das Paar aus Modell und Harness. Zweitens sind Zahlen aus verschiedenen Quellen nur dann vergleichbar, wenn dasselbe Harness benutzt wurde; selbst der Benchmark-Betreiber Epoch AI hat sein Standard-Scaffold im Februar 2026 ausgetauscht, worauf die Werte aller Modelle sprangen. Wer eine solche Zahl zitiert, nennt das Harness dazu – sonst ist sie ungefähr so aussagekräftig wie eine Laufzeit ohne Angabe des Rechners.
Übung
Ein Rissdetektor findet unter 200 Bauteilen 30 als „rissig“ markierte, davon sind 24 tatsächlich rissig; insgesamt gibt es 40 rissige Bauteile. Berechnen Sie Precision und Recall. Welche der beiden Zahlen würden Sie in der Qualitätssicherung höher gewichten, und warum?
Antwortprobe: die beiden Werte verhalten sich wie 4 zu 3, und der größere ist der, in dessen Nenner die 30 steht.