Das Perzeptron trainieren
Im letzten Kapitel haben wir das Perzeptron als Modell kennengelernt: ein Gewichtsvektor , ein Bias , und die Inferenz . Was fehlt, ist das Lernen. Bevor wir ein Modell implementieren, sollten wir uns ein paar Fragen stellen, die für jedes Modell in dieser Vorlesung wieder auftauchen werden:
Was sind die freien Parameter (Gewichte) des Modells – welche Variablen ändern sich beim Training?
Wie soll die Inferenz durchgeführt werden?
Wie funktioniert das Training?
supervised oder unsupervised?
Was genau erlauben wir für Datentypen?
Welche Berechnung passt die Gewichte an?
Was ist die Zielgröße – wann ist genug trainiert?
Welche Hyperparameter gibt es, und worauf legen wir sie fest?
Für das Perzeptron beantworten wir sie so.
Daten und Aufgabe. Das Perzeptron ist ein Modell zur binären Klassifikation, also Supervised Learning. Input sind Stichproben von , wobei Werte in hat und die Klasse ist. Die Dimensionalität der Eingabedaten ist ein Hyperparameter – einer, den wir in der Regel nicht optimieren wollen, weil er von den Daten vorgegeben ist. Ziel ist die Berechnung einer Funktion mit für einen möglichst kleinen Fehler .
Parameter und Inferenz. Die Parameter sind Gewichte , zusammengefasst zu , und der Bias . Die Inferenz ist
also genau dann, wenn . Mit dem Trick , aus dem letzten Kapitel schreiben wir im Folgenden einfach und denken uns den Bias als nulltes Gewicht.
Training: die Perzeptronregel. Gegeben die bisherigen Gewichte und ein einzelnes Sample , setze
Dabei ist ein Hyperparameter, die Lernrate. Was macht diese Regel?
Wenn , also bei korrekter Klassifikation, ist und damit : Nichts passiert.
Wenn , aber , so ist . Dann ist , und weil für alle gilt, ist die Aktivierung für dieses gewachsen – in Richtung der richtigen Entscheidung .
Wenn , aber , so ist , und die Aktivierung sinkt entsprechend.
Warum funktioniert das nicht nur für einen Schritt, sondern irgendwann sicher? Für ein festes Sample mit , das nach Updates immer noch falsch klassifiziert ist, gilt wegen der Bilinearität des Skalarprodukts
und dieser Wert wird für großes irgendwann positiv, egal wie schlecht war. Geometrisch: Jedes Update addiert ein Vielfaches von zu , dreht also Schritt für Schritt in Richtung (bei von weg), und die Entscheidungsgrenze, die senkrecht auf steht, dreht sich mit, bis auf der richtigen Seite liegt. Das ist die eine Rechnung, die man zu diesem Kapitel einmal selbst auf Papier gemacht haben sollte. Natürlich kann ein Update für ein anderes Sample auf die falsche Seite schieben; dass sich das nicht endlos wiederholt, ist die Aussage des Konvergenzsatzes.
Die Regel schiebt also die Trennhyperebene bei jedem Fehler ein Stück in Richtung des falsch klassifizierten Punkts. Falls die Daten linear trennbar sind, findet sie nach endlich vielen Fehlern eine trennende Hyperebene; falls nicht, terminiert das Verfahren nie von selbst.
Vertiefung: der Perzeptron-Konvergenzsatz
(Novikoff 1962.) Seien die Label als kodiert. Angenommen, es gibt einen Einheitsvektor und eine Margin mit für alle , und alle Datenpunkte erfüllen . Dann macht die Perzeptronregel mit Start höchstens Fehler, unabhängig von der Lernrate, der Dimension und der Anzahl der Datenpunkte.
Beweisidee: Bei jedem Fehler wächst um mindestens , nach Fehlern also auf mindestens . Gleichzeitig wächst bei jedem Fehler um höchstens , denn , und der mittlere Term ist bei einem Fehler nicht positiv. Nach Fehlern ist also . Mit Cauchy-Schwarz folgt , also . Das Verfahren nutzt die Margin, ohne sie zu kennen.
Zielgröße. Wir messen den Erfolg als Anteil falsch klassifizierter Samples (Fehlerrate), bzw. als Anteil korrekt klassifizierter Samples (Accuracy) auf einem Testset.
Initialisierung. Irgendwo muss anfangen; wir initialisieren z.B. auf den Vektor . Auch das ist eine Entscheidung mit Konsequenzen, wie wir später sehen werden.
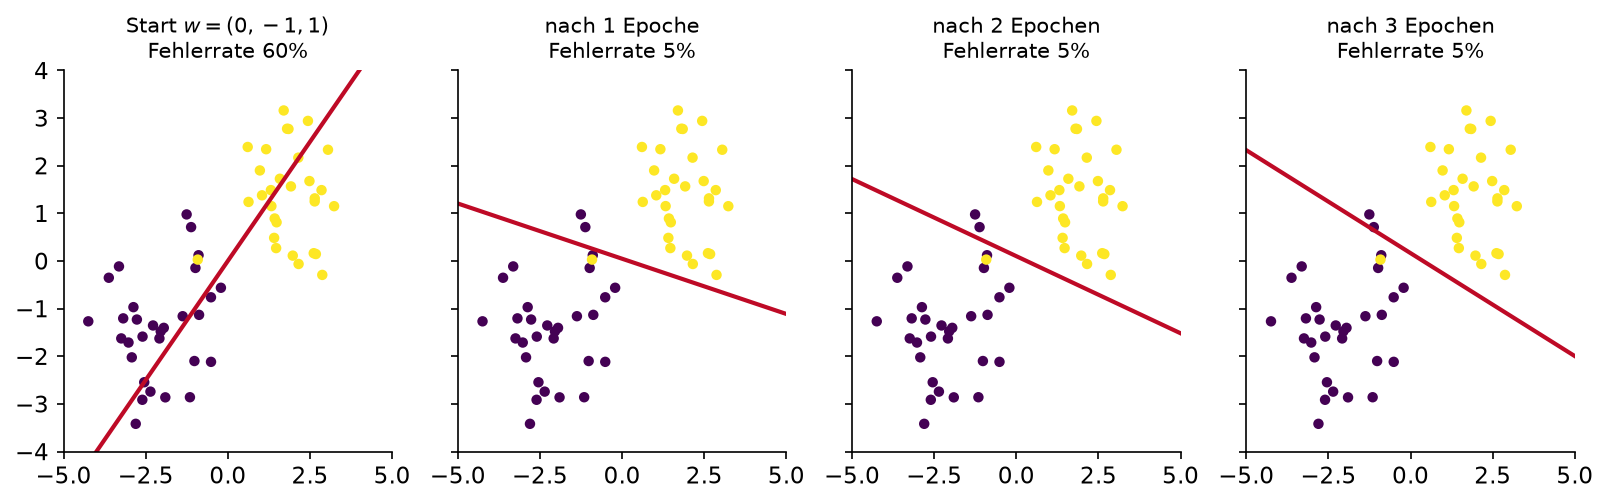
Die Perzeptronregel bei der Arbeit: Trenngerade nach 0, 1, 2 und 3 Epochen über 60 Datenpunkte, Lernrate .
Zurück in die Theorie: Wozu das olle Perzeptron?
Moderne neuronale Netze verwenden meist keine Perzeptrons mehr. Beliebter ist die multiple lineare oder die logistische Regression, die ebenfalls gleich strukturierte Eingabedaten annimmt und sehr ähnlich verarbeitet: Skalarprodukt, gefolgt von einer nichtlinearen Funktion. Dieses Kochrezept – die gemeinsame Verallgemeinerung – heißt manchmal auch einfach „Perzeptron“.
Die Wahl von bestimmt, welches bekannte Modell wir vor uns haben – und wie man es trainiert:
| Modell | Training | |
|---|---|---|
| Lineare Regression | kleinste Quadrate | |
| Perzeptron | Perzeptronregel | |
| „stetiges Perzeptron“ | ? | |
| Logistische Regression | ? |
Die letzten beiden Zeilen sind stetige, sogar differenzierbare Versionen der Sprungfunktion : bildet nach ab, die logistische Sigmoidfunktion nach . Die offene Frage ist die Update-Regel: Wie trainiert man ein verallgemeinertes Perzeptron mit beliebigem ? Die Antwort – Gradientenabstieg auf einer Loss-Funktion – werden wir in den nächsten Kapiteln eingehend studieren; die Perzeptronregel wird sich dabei als Spezialfall erweisen.
Mehrere Schichten
Warum die Perzeptronregel nicht reicht
Angenommen, und sind die Gewichte von zwei Perzeptrons,
und ist der Ergebnisvektor der ersten Schicht. Ein drittes Perzeptron mit Gewichten berechnet daraus
Das ist ein Multilayer Perceptron mit einer versteckten Schicht. Die Perzeptronregel sagt uns, wie wir anpassen, wenn falsch liegt – aber sie sagt nichts darüber, wie und angepasst werden sollten. Welches der beiden Perzeptrons in der ersten Schicht war „schuld“? Die Antwort auf diese Frage heißt Backpropagation, und sie braucht ein , das sich ableiten lässt. Die Sprungfunktion des Perzeptrons tut das nicht; ReLU dagegen wird überall benutzt, obwohl sie bei 0 einen Knick hat (siehe Kapitel „Aktivierungsfunktionen“). Das machen wir noch.
Warum lineare Regression keine Schichten braucht
Man könnte auf die Idee kommen, statt Perzeptrons einfach lineare Regressionen zu stapeln, die haben ja ein bekanntes Trainingsverfahren. Seien also und zwei lineare Regressionen, , und . Dann ist
Das ist äquivalent zu einer einzigen linearen Regression mit Gewichtsvektor . Allgemein: Ein Produkt von Matrizen ist wieder eine Matrix, mehrere lineare Schichten hintereinander sind wieder eine lineare Schicht. Ohne die Nichtlinearität zwischen den Schichten bringt Tiefe gar nichts. Genau deshalb heißt auch Aktivierungsfunktion und nicht Dekoration.
Übung
Gegeben ein Datenpunkt mit Label und ein Perzeptron mit , also : Das Perzeptron sagt 0, richtig wäre 1.
Führen Sie einen Schritt der Perzeptronregel mit aus.
Berechnen Sie . Um wie viel hat sich die Aktivierung geändert? Tipp: Rechnen Sie die Differenz einmal allgemein mit der Bilinearität des Skalarprodukts aus – Sie bekommen , unabhängig von .
Wie viele solche Schritte braucht es mindestens, bis die Aktivierung positiv wird?
Antwortprobe: eine ganze Zahl, ohne Iteration ausrechenbar. Machen Sie die Gegenprobe mit einem Schritt weniger – dort muss die Aktivierung noch sein, denn in steht ein echtes Größerzeichen.