Motivation zur Faltung
Bildverarbeitung: it’s a blur
Wer schon einmal ein Bild in GIMP oder Photoshop weichgezeichnet hat, hat eine Faltung benutzt: Jeder Pixel wird durch einen gewichteten Mittelwert seiner Nachbarn ersetzt. Und wer Kanten gefunden hat („make a difference“): Das Originalbild minus das weichgezeichnete Bild lässt genau die Stellen übrig, an denen sich benachbarte Pixel stark unterscheiden – die Kanten.
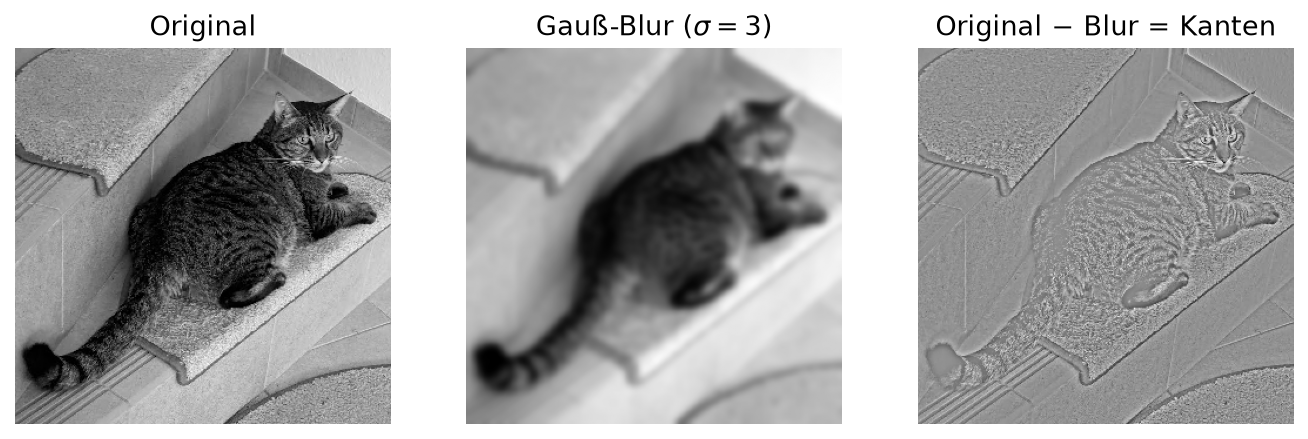
Faltung in der Bildverarbeitung: Original, mit einer Gaußfunktion weichgezeichnet, und die Differenz beider – die Kanten.
Das menschliche Auge erkennt Kanten(orientierung)
Hubel & Wiesel (1959) haben in der Sehrinde von Katzen Neuronen gefunden, die auf Balken einer bestimmten Orientierung antworten – und auf andere Orientierungen nicht (Reproduktion von Wurtz 1969, in Robert H. Wurtz: „Recounting the impact of Hubel and Wiesel“, J Physiol 2009). Solche Neuronen sind lokale Kantendetektoren: Sie schauen auf einen kleinen Ausschnitt des Gesichtsfelds und reagieren auf ein bestimmtes Muster darin. CNNs sind die technische Umsetzung dieser Idee, und die ersten Schichten eines trainierten CNN sehen tatsächlich aus wie Kantendetektoren verschiedener Orientierung.
Das klassische Bild dazu, ein Neuron, das nur bei einer Balkenorientierung feuert, steht im Wikipedia-Artikel zu Hubel und Wiesel (Orientation column, Abbildung CC-BY-SA).
In der Informatik
Abgesehen von CNNs ist die Faltung das zentrale Instrument in der Signalverarbeitung. Das Eindimensionale ist leichter zu verstehen als das Zweidimensionale, damit fangen wir an.
Eindimensionale Faltung
Eine Interpretation: ist das Signal, der sogenannte Filter (oder Kernel). Der Filter ist kurz ( Werte), das Signal lang.
Interpretation der Definition
Da steht ein Skalarprodukt des Vektors mit . Rechnung: Nimm einen -Ausschnitt von , zentriert bei , dann flippen (bei spiegeln) und dann Skalarprodukt mit . Das Flippen ist der Unterschied zwischen Faltung und Korrelation; für symmetrische Filter () ist es egal, und in Deep-Learning-Bibliotheken wird tatsächlich meist die Korrelation berechnet und trotzdem „Convolution“ genannt. Da die Filter gelernt werden, spielt es keine Rolle.
Ein Faltungsfilter ist also ein Neuron mit Gewichten, das an jeder Position des Signals dasselbe Skalarprodukt mit dem lokalen Ausschnitt berechnet. Dieselben Gewichte an jeder Position: das heißt Parameter Sharing, und es hat zwei Konsequenzen. Erstens hat die Schicht nur Parameter, egal wie lang das Signal ist. Zweitens ist die Faltung translationsäquivariant: Verschiebt man das Signal, verschiebt sich das Ergebnis genauso.
Beispiel: ASML-Aktienkurs
Wir möchten ein Signal mit einem Filter falten. Das Signal ist der ASML-Aktienkurs in US-Dollar (closing price adjusted for splits, ein Teildatensatz über 5 Jahre); der Filter ist eine schmale Gaußfunktion (gaussian_narrow). Das Ergebnis ist der geglättete Kurs: Die Gaußfunktion ist ein gewichteter gleitender Mittelwert, und je breiter sie ist, desto glatter das Ergebnis. Faltung mit einem Peak (einer diskreten Delta-Funktion) gibt das Signal unverändert zurück; Faltung mit einer Kastenfunktion ist der ungewichtete gleitende Mittelwert; Faltung mit der Differenz zweier Gaußfunktionen (Difference of Gaussians, DoG) hebt Änderungen hervor und ist ein Kantendetektor. (Tipp: „DoG filter“ ist kein Snapchat-Filter.)
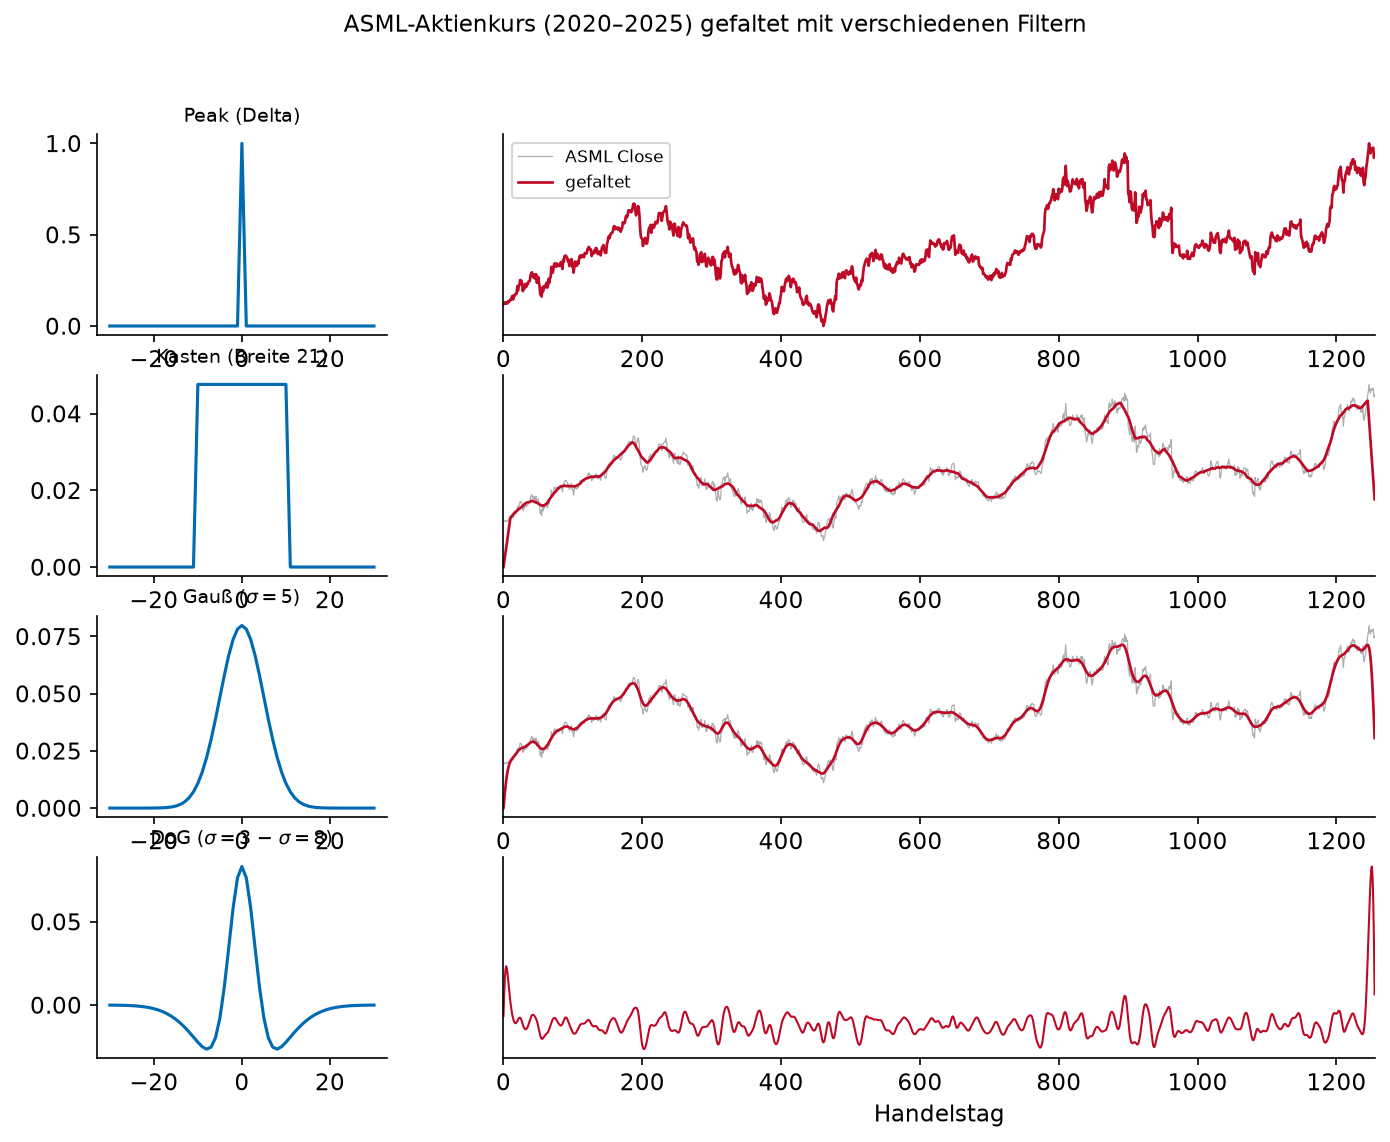
Der ASML-Aktienkurs (Schlusskurse 2020–2025) gefaltet mit vier Filtern. Delta lässt das Signal unverändert, Kasten und Gauß glätten, die Difference of Gaussians hebt Änderungen hervor.
Programmierung
Für NumPy-Arrays gibt es scipy.signal.convolve. Der Filter ist einfach ein Array von Funktionswerten auf einem Gitter, und mode='same' sorgt per Zero-Padding dafür, dass das Ergebnis so lang ist wie das Signal:
import numpy as np
import pandas as pd
from scipy.signal import convolve

data = pd.read_csv("ASML.csv")["Close"].to_numpy()   # Schlusskurse als Array

x = np.linspace(-6, 6, 1000)
kernel = np.exp(-x**2 / (2 * 0.1**2))          # schmale Gaußfunktion
kernel /= kernel.sum()                         # normieren, sonst skaliert der Kurs
smoothed = convolve(data, kernel, mode='same') # data: die Schlusskurse als Array
Für Tensoren nimmt man torch.nn.functional.conv1d, und dort muss man sich an die Dimensionen gewöhnen: Eingabe und Filter haben den Shape (batch, channels, length) bzw. (out_channels, in_channels, kernel_size), also für ein einzelnes Signal und einen einzelnen Filter zweimal unsqueeze(0):
import torch
import torch.nn.functional as F

signal = torch.tensor(data, dtype=torch.float32).unsqueeze(0).unsqueeze(0)  # (1, 1, N)
filt = torch.tensor([-1.0, -1, 1, 1, 1]).view(1, 1, 5)                      # (1, 1, 5)
out = F.conv1d(signal, filt, padding=2).squeeze()                           # wieder (N,)
Ein Difference-of-Gaussians-Filter entsteht als Differenz zweier normierter Gaußkerne verschiedener Breite:
def gaussian_1d(size, sigma):
    t = torch.arange(size).float() - size // 2
    g = torch.exp(-t**2 / (2 * sigma**2))
    return g / g.sum()

dog = gaussian_1d(11, sigma=1) - gaussian_1d(11, sigma=20)
out = F.conv1d(signal, dog.view(1, 1, -1), padding=5).squeeze()
Was man dabei beobachtet: Ein Faltungslayer, den man auf solchen Zeitreihen lernen lässt, findet von selbst Filter, die wie Gauß- oder DoG-Kerne aussehen – Glätten und Änderungen hervorheben sind schlicht die nützlichsten Operationen.
Das Faltungstheorem
Für zwei stetige Funktionen und die stetige Faltung (Integral statt Summe) gilt für die Fourier-Transformation :
d.h. Faltung im Ortsraum ist Multiplikation im Frequenzraum. Auch umgekehrt: . Konkret: Mit einer reinen Sinuswelle zu falten heißt, den Koeffizienten dieser Welle in der Zerlegung des Signals herauszugreifen. Aus dem Faltungstheorem folgen auch die Assoziativität und die praktische Regel
d.h. „glätten und dann ableiten“ ist dasselbe wie „mit dem abgeleiteten Filter falten“ – man faltet also gleich mit der Ableitung der Gaußfunktion, statt erst zu glätten. Der DoG-Filter gehört eine Stufe höher: Die Differenz zweier Gaußfunktionen verschiedener Breite nähert die zweite Ableitung an (es ist ), und Kanten sind dort die Nulldurchgänge. Die erste Ableitung der Gaußfunktion ist eine ungerade Funktion, der DoG-Filter eine gerade – ähnlich sehen sie nur auf den ersten Blick aus. Das Faltungstheorem erklärt auch, warum die Gaußfunktion glättet: Ihre Fouriertransformierte ist wieder eine Gaußfunktion, die hohe Frequenzen (= schnelle Änderungen, Rauschen) dämpft. Kurzer Ausflug in die Fourier-Transformation? Andrew Zisserman, Lecture 2.
Eindimensionales Pooling
Pooling ≈ Binning
Binning = Array in feste disjunkte Blöcke (ohne Überlapp) zerlegen, dann Summe oder Mittelwert bilden. Das ist ungefähr eine Faltung mit einer Kastenfunktion, bei der man aber nur wenige Werte des Ergebnisses verwendet. Wie viel Überlapp es gibt, bestimmt der Stride (Schrittlänge).
Pooling = Array in feste Blöcke (mit Überlapp) einteilen. Average-Pooling = Pooling + Mittelwert der Blöcke. Max-Pooling = Pooling + Maximum der Blöcke.
Pooling-Beispiel
Pooling eines Vektors :
Mit Stride 1 und Poolgröße 2: Pools .
Mit Stride 2 und Poolgröße 2: Pools ; Average-Pooling gibt .
Mit Stride 1 und Poolgröße 3: Pools ; Max-Pooling gibt .
Von 4 Inputs reduzieren wir die Datenmenge also auf 3 oder 2 Outputs, je nach Größe und Stride. Pooling ist Dimensionsreduktion ohne Parameter, und Max-Pooling macht das Netz ein Stück weit translationsinvariant: Es ist egal, wo genau im Pool das Maximum lag.
Ein Stride größer als 1 kann man auch direkt bei der Faltung verwenden (strided convolution), dann reduziert die Faltung selbst die Dimension.
Zweidimensionale Faltung
Für Bilder (Graustufen) und Filter :
Ein -Filter hat 9 Gewichte, die an jeder Pixelposition dasselbe Skalarprodukt mit der -Nachbarschaft bilden. Beispiel mit GIMP: Unter Filter Allgemein Faltungsmatrix kann man die 9 Werte selbst eintragen und sieht unten den Output der 2D-Faltung – Weichzeichner, Schärfen, Kanten, Relief sind alles nur verschiedene Matrizen.
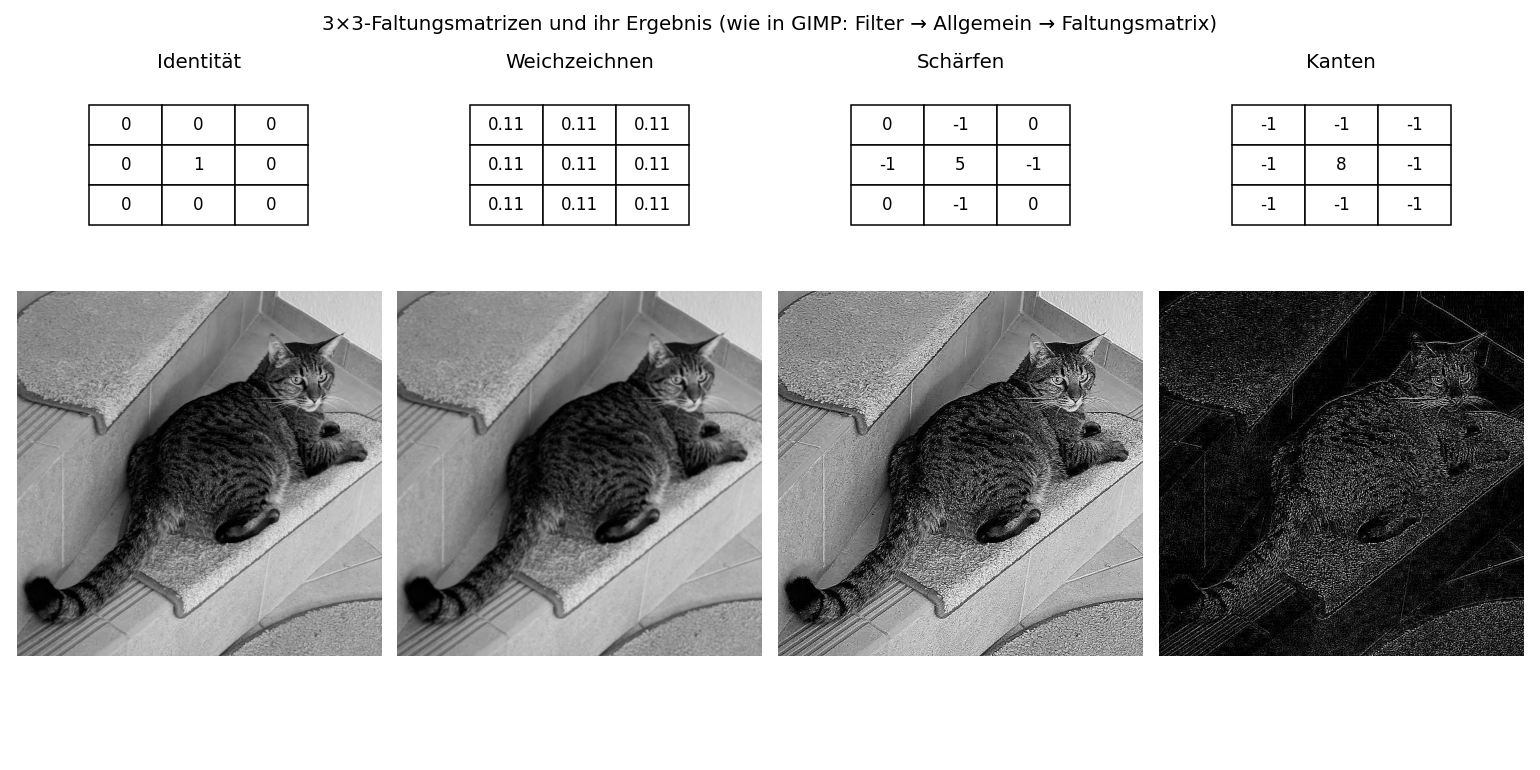
Vier -Faltungsmatrizen und ihr Ergebnis auf demselben Graustufenbild (notebooks/pallino.jpg): Identität, Weichzeichnen (Mittelwert), Schärfen, Kanten. Genau so funktioniert der Dialog Faltungsmatrix in GIMP.
Bei Farbbildern hat die Eingabe 3 Kanäle (RGB), und ein Filter hat dann Shape : Er summiert über alle Eingabekanäle. Eine Faltungsschicht mit Filtern erzeugt Ausgabekanäle (Feature Maps). Ein -Filter schaut nur auf einen Pixel, aber über alle Kanäle – das ist ein linearer Layer pro Pixel und wird benutzt, um die Anzahl der Kanäle zu ändern, ohne die räumlichen Dimensionen anzurühren.
CNNs
Ein Convolutional Neural Network ist ein neuronales Netz, in dem (einige) Schichten Faltungen sind: nn.Conv1d bzw. nn.Conv2d mit lernbaren Filtergewichten, gefolgt von einer Aktivierungsfunktion, oft gefolgt von Pooling. Typische Architektur für Bildklassifikation: mehrere Blöcke aus Conv ReLU MaxPool, wobei die räumliche Auflösung sinkt und die Anzahl der Kanäle steigt, dann flatten und ein oder zwei lineare Schichten mit Softmax. Die Faltungsschichten lernen in den frühen Layern allgemeine Merkmale wie Kanten und Ecken, in späteren Layern zusammengesetzte Muster.
Man beachte: Jede Berechnung mit einem Faltungslayer kann auch mit einem linearen (fully connected) Layer durchgeführt werden – die Faltung ist ja linear, also eine Matrix, nur eine sehr spezielle mit vielen Nullen und wiederholten Einträgen. Der Punkt der Faltung ist nicht, dass sie mehr kann, sondern dass sie mit viel weniger Parametern das Richtige kann, wenn die Daten lokale, verschiebungsinvariante Struktur haben. Und man muss nicht alle Layer zu Faltungen machen; die letzten Schichten eines CNN sind fast immer linear.
Ausgabegröße einer Faltungsschicht
Wie groß ist die Feature Map nach einer Faltung? Bei Eingabelänge , Kernelgröße , Padding (Nullen an jedem Rand) und Stride ist die Ausgabelänge
pro Dimension. Ohne Padding („valid“) schrumpft das Bild also um ; mit („same“) bleibt es gleich groß. Pooling folgt derselben Formel mit = Poolgröße. Beispiel für ein kleines CNN auf -Bildern (MNIST):
nn.Conv2d(1, 8, kernel_size=5)      # 28 -> 24, 8 Kanäle
nn.MaxPool2d(kernel_size=2, stride=2)  # 24 -> 12
nn.Conv2d(8, 16, kernel_size=5)     # 12 -> 8, 16 Kanäle
nn.MaxPool2d(kernel_size=2, stride=2)  # 8 -> 4
nn.Flatten()                        # 16 * 4 * 4 = 256
nn.Linear(16 * 4 * 4, 10)
Die Zahl im nn.Linear muss man also ausrechnen – der häufigste Shape-Fehler beim Bau eines CNN. Mit kernel_size=3 statt 5 wären es , also 16 * 5 * 5.
2-dimensionale Faltung in PyTorch
nn.Conv2d ist ein Layer mit lernbaren Gewichten; man kann die Gewichte aber auch von Hand setzen und den Layer als Bildfilter benutzen. Ein Farbfoto wird zu einem Tensor der Form (1, 3, H, W) (Batch, RGB-Kanäle, Höhe, Breite), und ein Filter mit in_channels=3 summiert über die drei Farbkanäle:
import torch, torch.nn as nn
from PIL import Image
from torchvision import transforms

img = transforms.ToTensor()(Image.open("pallino.jpg")).unsqueeze(0)  # notebooks/pallino.jpg, (1, 3, H, W)

conv = nn.Conv2d(in_channels=3, out_channels=1, kernel_size=5, padding=1, bias=False)
w = torch.full((5, 5), -1.0)        # überall -1 ...
w[2, 1:4] = 7.0                     # ... außer drei Werten in der Mitte: 7
conv.weight.data = w.expand(1, 3, 5, 5).clone()   # derselbe Filter auf allen Kanälen

out = torch.clamp(conv(img), 0, 1).squeeze()      # (H', W'), auf [0, 1] gekappt
Die Gewichte summieren sich zu : In gleichmäßigen Flächen ist die Antwort leicht negativ und wird auf 0 gekappt, nur dort, wo die drei Mittelpixel heller sind als ihre Umgebung – an Kanten und Texturen – bleibt etwas übrig. Das Ergebnis hat einen Kanal, ist also ein Graustufenbild; unten in Falschfarben.
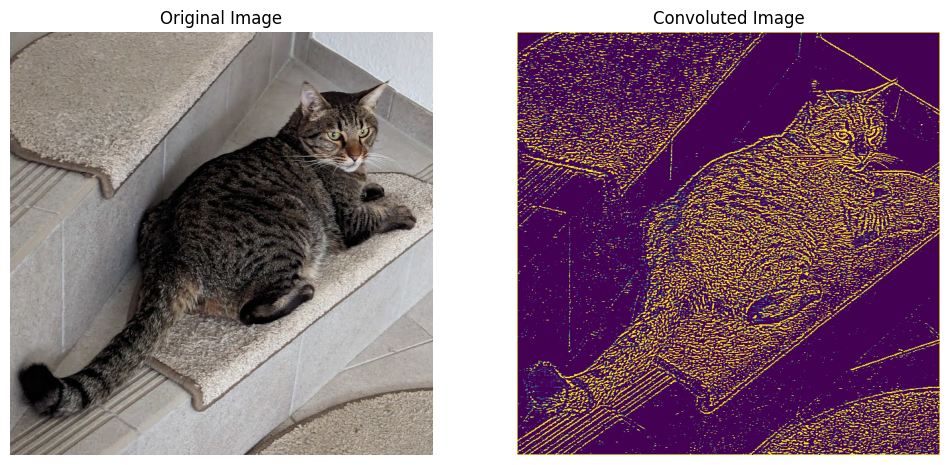
nn.Conv2d mit dem handgesetzten -Filter oben: Aus einem Foto wird ein Kantenbild. Ein CNN lernt solche Filter selbst – in der ersten Schicht sehen sie meist genau so aus.
Weiterführend:
Animationen von Vincent Dumoulin und Francesco Visin zu Padding, Stride und Dilation: github
.com /vdumoulin /conv _arithmetic. Interaktives MNIST-CNN-Explorationswerkzeug von Adam Harley: adamharley
.com /nn _vis /cnn /2d .html – man zeichnet eine Ziffer und sieht alle Feature Maps aller Schichten. Universal Fourier Features Emerge (arXiv:2312.08550): warum gelernte Filter so oft wie Fourier-Basisfunktionen aussehen.
Faltung und Pooling einmal von Hand zu rechnen lohnt sich; ein Übungsblatt tut genau das.
Übung
Signal an den Stellen , Filter an den Stellen .
Berechnen Sie für mit . Tipp: Nur drei Summanden je Stelle, und einer davon fällt weg.
Berechnen Sie Max-Pooling von mit Poolgröße 2 und Stride 2.
Ein -Bild geht durch
Conv2d(1, 16, kernel_size=5), dannMaxPool2d(2), dannConv2d(16, 16, kernel_size=5), dannMaxPool2d(2). Welchen Shape hat die Ausgabe, und wie viele Werte hat sie nachFlatten? Tipp: , hier ohne Padding.
Antwortprobe: Bei (3) kommt heraus – die Zahl taucht in PyTorch-Beispielen ständig auf.