Historie
NeurIPS 2014
Goodfellow et al., Generative Adversarial Nets: „We propose a new framework for estimating generative models via adversarial nets, in which we simultaneously train two models: a generative model that captures the data distribution, and a discriminative model that estimates the probability that a sample came from the training data rather than . The training procedure for is to maximize the probability of making a mistake. This framework corresponds to a minimax two-player game. In the space of arbitrary functions and , a unique solution exists, with recovering the training data distribution and equal to everywhere. In the case where and are defined by multilayer perceptrons, the entire system can be trained with backpropagation.“
Der letzte Satz ist der Punkt: Kein Markov-Chain-Sampling, keine Variationsrechnung wie beim VAE – nur zwei Netze und Backpropagation.
LeCun 2016
Yann LeCun, auf Quora: „There are many interesting recent developments in deep learning […] The most important one, in my opinion, is adversarial training (also called GAN for Generative Adversarial Networks). This is an idea that was originally proposed by Ian Goodfellow when he was a student with Yoshua Bengio at the University of Montreal […] This, and the variations that are now being proposed is the most interesting idea in the last 10 years in ML, in my opinion.“
GANs technisch
Aufbau
Zwei Netze: Der Generator bekommt einen zufälligen latenten Vektor (das Rauschen) und erzeugt daraus ein Sample , z.B. ein Bild. Der Diskriminator bekommt ein Bild – entweder ein echtes aus dem Trainingsdatensatz oder ein generiertes – und gibt eine Wahrscheinlichkeit aus, dass das Bild echt ist. Man beachte: Der Generator bekommt nie echte Bilder als Input; er sieht die Daten nur indirekt, über den Gradienten des Diskriminators.
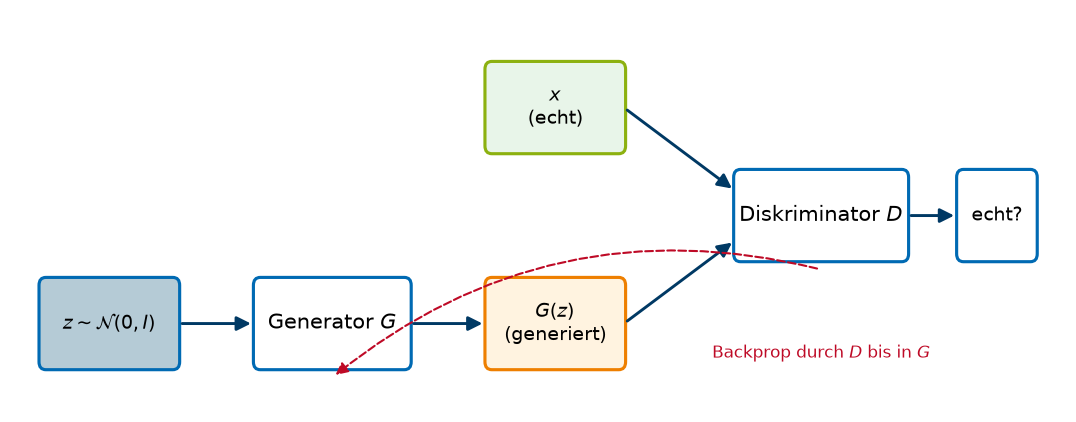
Generator und Diskriminator. Der Generator sieht nie echte Daten – nur den Gradienten, der durch den Diskriminator zurückfließt.
Erinnerung: Samples generieren
Der Generator generiert Samples aus einer Verteilung. Diese Verteilung ist, was im (Pre-)Training gelernt wird, indem die Samples aus dem Trainingsdatensatz als latente Vektoren repräsentiert werden. Generatives Modell = Verteilung lernen (Kapitel „Was ist Deep Learning?“). Beim VAE haben wir dafür den latenten Raum explizit auf eine Normalverteilung gezwungen; beim GAN sagt uns der Diskriminator, ob die generierte Verteilung schon von der echten zu unterscheiden ist.
GAN-Training
Das Minimax-Spiel aus dem Abstract als Formel:
Das ist die negative binäre Kreuzentropie des Diskriminators mit Label 1 für echt und 0 für generiert – in der Schreibweise aus dem Kapitel „Loss-Funktionen und Maximum Likelihood“ also , ohne den Faktor . Deshalb maximiert sie – gut klassifizieren heißt ja, die Kreuzentropie klein zu machen –, und minimiert sie ( täuschen). In der Praxis werden beide abwechselnd mit Gradientenabstieg trainiert:
Diskriminator: Er bekommt eine Penalty in der Loss-Funktion für die Fehlklassifikation eines Eingabebildes, also sowohl für falsch positive („echt“ behauptet, war aber generiert) als auch falsch negative („generiert“ behauptet, war aber echt). Ein Schritt: ein Batch echter Bilder mit Label 1, ein Batch generierter Bilder mit Label 0, BCE-Loss, backward, step – nur die Parameter von .
Generator: Nach einem optionalen Pretraining (z.B. als Decoder eines Autoencoders, um die Verteilung der Trainings-Samples grob zu lernen) wird der Generator zusammen mit dem Diskriminator trainiert (Finetuning). Dazu bekommt der Generator eine Penalty in der Loss-Funktion für das Generieren von Bildern, die der Diskriminator als generiert erkennt: ein Batch , durch schicken, BCE-Loss mit Label 1 (der Generator will, dass „echt“ sagt), backward, step – nur die Parameter von . Der Gradient fließt dabei durch hindurch bis in , das ist Backpropagation durch zwei Netze.
Im Gleichgewicht, wenn die Datenverteilung exakt trifft, kann nicht besser als raten: .
GAN-Modelle
Der Diskriminator kann ein einfaches Multilayer Perceptron sein, d.h. mehrere lineare Layer und zuletzt ein einzelnes Neuron zur Klassifikation „ist das echt?“ in 0 oder 1 – also logistische Regression auf Features. Alternativ kann der Diskriminator auch aus 2 Komponenten bestehen, wobei zunächst ein vortrainierter Encoder das Bild in latente Vektoren umrechnet, die dann an einen Klassifikator weitergegeben werden. Dabei kann z.B. ein CNN zur Extraktion von Features sinnvoll sein.
Der Generator kann ein einfaches Multilayer Perceptron sein, etwa der Decoder eines Autoencoders, sodass es einen latenten Raum gibt, aus dem man sampeln kann. Mit Faltungen (genauer: transponierten Faltungen, die die Auflösung erhöhen) im Generator und einem CNN im Diskriminator heißt das DCGAN (deep convolutional GAN, Radford et al. 2015).
Ausprobieren: GAN Lab
Varianten von GANs
Conditional GANs
Generator und Diskriminator bekommen Zusatzinformationen, z.B. Klassenlabels: Der Generator generiert bedingt auf ein gegebenes Klassenlabel , der Diskriminator entscheidet bedingt zum Klassenlabel. So bekommt man einen Generator, dem man sagen kann, welche Ziffer er zeichnen soll (die vierte MNIST-Task aus dem Kapitel „Autoencoder“). Geht auch mit anderen Zusatzinformationen, z.B. Text kodiert als Vektor von Wort-Embeddings – das ist der Weg zu Text-zu-Bild-Modellen.
Wasserstein GANs – wozu?
Probleme mit klassischen GANs bei der Bildgenerierung:
Mode Collapse – der Generator produziert nur (noch) stereotype Bilder ohne große Variation. Die Verteilung kollabiert auf die Moden, also die Wahrscheinlichkeitsmasse konzentriert sich auf einige wenige Punkte, die gerade nicht erkennt.
Vanishing Gradients – wenn der Diskriminator zu schnell gut wird, ist überall, ist flach, und der Lernprozess geht für den Generator nicht weiter.
Instabilität im Training – die Loss-Funktion des Generators entspricht nicht unbedingt der Qualität der Bilder; man kann am Loss nicht ablesen, ob es besser wird.
Wasserstein GANs – was?
Andere Loss-Funktion: die Wasserstein-Distanz, auch „Earth Mover’s Distance“ – wie viel Wahrscheinlichkeitsmasse (mal Weglänge) bewegt werden muss, um aus einer Verteilung eine andere zu machen (analog zur Levenshtein-Distanz als Editierabstand für Strings). Die Verteilungen sind zum einen die echten Bilder, zum anderen die generierten Bilder (je ein Batch). Der Vorteil gegenüber der KL-Divergenz bzw. der Kreuzentropie: Die Wasserstein-Distanz ist auch dann endlich und hat einen nützlichen Gradienten, wenn sich die beiden Verteilungen gar nicht überlappen.
Kritiker statt Diskriminator: Statt einer Wahrscheinlichkeit in gibt der Kritiker eine reelle Zahl aus und schätzt damit die Wasserstein-Distanz zwischen den realen Bildern und den gegebenen Bildern. Wenn der Kritiker alle Bilder für echt hält, schätzt er 0, ansonsten gibt es ein Signal, welches für das Training genutzt werden kann. Beides führt zu glatteren Loss-Landschaften und damit zu effektiverem Gradientenabstieg, und der Kritiker-Loss korreliert tatsächlich mit der Bildqualität.
Vertiefung: warum der Kritiker die Wasserstein-Distanz schätzt
Die Wasserstein-1-Distanz zwischen zwei Verteilungen und ist als Transportproblem definiert. Die Kantorovich-Rubinstein-Dualität sagt, dass man sie auch so schreiben kann:
ein Supremum über alle Funktionen , die höchstens Steigung 1 haben (1-Lipschitz). Der Kritiker ist dieses : ein Netz, das auf echten Bildern hohe und auf generierten Bildern niedrige Werte ausgeben soll; die Differenz der Mittelwerte ist die geschätzte Distanz. Damit das eine Schranke bleibt, muss der Kritiker Lipschitz-beschränkt bleiben: im Original-WGAN (Arjovsky et al. 2017) durch Abschneiden der Gewichte (weight clipping), in WGAN-GP (Gulrajani et al. 2017) durch einen Strafterm auf die Gradientennorm (gradient penalty). Tutorial: Lilian Weng, From GAN to WGAN.
Konkrete Modelle
CycleGAN
Zhu, Park, Isola, Efros (ICCV 2017), Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks: Image-to-image translation lernt die Abbildung von einem Eingabebild auf ein Ausgabebild – normalerweise aus einem Trainingsdatensatz gepaarter Bilder. Für viele Tasks gibt es aber keine Paare (Foto Monet-Gemälde, Pferd Zebra, Sommer Winter). CycleGAN lernt eine Abbildung , sodass die Verteilung von von nicht unterscheidbar ist (adversarial loss) – und weil das allein hochgradig unterbestimmt ist, gleichzeitig die inverse Abbildung mit einem Cycle-Consistency-Loss (und umgekehrt). Ein Pferd, das zum Zebra und zurück wird, muss wieder dasselbe Pferd sein.
Beispielbilder (Monet Foto, Zebra Pferd, Sommer Winter) auf der Projektseite junyanz
StyleGAN
Karras, Laine, Aila – NVIDIA (CVPR 2019), A Style-Based Generator Architecture for Generative Adversarial Networks: eine alternative Generator-Architektur, die sich an der Style-Transfer-Literatur orientiert. Der latente Vektor wird zuerst durch ein MLP in einen Zwischenraum abgebildet und dann auf jeder Auflösungsstufe des Generators als „Stil“ eingespeist. Das führt zu einer automatisch gelernten, unsupervised Trennung von High-Level-Attributen (z.B. Pose und Identität bei Gesichtern) und stochastischer Variation (z.B. Sommersprossen, Haare), und erlaubt intuitive, skalenspezifische Kontrolle der Synthese. Dazu ein neuer Datensatz von Gesichtern (FFHQ). StyleGAN2 ist hinter thispersondoesnotexist
Beispielgesichter und das Video zur Interpolation im Stil-Raum: github
Viele konkrete Modelle
The GAN Zoo, github
Selbst GANs basteln
Tutorial time: pytorch