Zwei Themen zum Abschluss, die über die Vorlesung hinausgehen, aber mit dem Gelernten schon verständlich sind.
Adversarial Attacks
Definition
Die gezielte Manipulation des Inputs eines Machine-Learning-Modells, um ein spezifisch falsches Ergebnis oder ein unerwartetes Verhalten zu produzieren. Die Manipulation ist häufig nicht direkt für Menschen zu erkennen.
Beispiel: die gezielte Manipulation des Inputs eines Bildklassifikators, um eine spezifisch falsche Klasse zu produzieren. Also: Wir stecken einen weißen Hai rein, aber „die KI“ sagt „Goldfisch“ dazu. Reingelegt!
Theorie
Wir betrachten den Eingaberaum „Menge aller Bilddateien“ () sowie die Eingabemenge „Menge aller Trainingsbilder“. Das Modell lernt Entscheidungsgrenzen im Eingaberaum, um Klassenlabel zu vergeben. Hypothese: Nahe der Entscheidungsgrenze liegen adversarial examples – und da die Trainingsbilder nur auf einer winzigen Teilmenge des Eingaberaums liegen (Manifold-Hypothese), verläuft die Entscheidungsgrenze fast überall dicht an jedem Bild vorbei, nur in Richtungen, die „aus der Mannigfaltigkeit heraus“ zeigen und für Menschen wie Rauschen aussehen.
Das ist die These der Bachelorarbeit „Das Dimpled Manifold Model als Erklärung für die Existenz und die Eigenschaften von Adversarial Examples“ von N. Wieczorek (HHU 2023), nach Shamir et al. 2021: Die Entscheidungsgrenze schmiegt sich wie eine Folie mit kleinen Dellen (dimples) an die Datenmannigfaltigkeit an.
Wie wird’s gemacht?
Mit Gradientenabstiegsmethoden sucht man, ausgehend von einem Bild eines weißen Hais, Richtungen, die die Klassifikation ändern, ohne besonders viel am Bild zu ändern: ein Schritt in Richtung des Gradienten des Loss nach dem Bild oder viele kleine Schritte. Anders als sonst: Gradientenabstieg im Eingaberaum, nicht im Gewichtsraum – Backpropagation liefert genauso wie , denn im DAG ist nur ein weiteres Blatt. Genau das tut auch das „Dreaming“ im Notebook latent-classifier.ipynb zum Kapitel „LLMs benutzen“: Es sucht per Adam im Raum der Eingabe-Embeddings nach einem Text, der den Spam-Detektor maximal triggert – ein adversarial example ohne den Anspruch, unauffällig zu sein.
Vertiefung: Fast Gradient Sign Method
Goodfellow, Shlens und Szegedy 2014: Mit dem Loss für das wahre Label ist
ein Bild, das sich in jedem Pixel um höchstens vom Original unterscheidet und den Loss in erster Näherung maximal vergrößert. Gezielt auf eine Wunschklasse : Minus statt Plus und statt . Ein einziger Gradientenschritt genügt oft, weil das Modell in der Umgebung des Bildes fast linear ist; die iterative Variante (PGD) macht viele kleine Schritte und projiziert nach jedem zurück in den -Würfel um .
Dass das nicht nur mit Pixeln funktioniert: Sharif et al. 2016, Accessorize to a Crime: Real and Stealthy Attacks on State-of-the-Art Face Recognition – eine bedruckte Brillenfassung lässt ein Gesichtserkennungssystem eine andere Person erkennen. Und aus dem Heise-Newsticker vom 2.2.2026: Manipulierte Straßenschilder: Wenn das autonome Auto Fußgänger umfährt.
Polysemie und die Manifold-Hypothese
(Folien von Ben Ruppik, aus der Vorlesung Topological Data Analysis im Master AI & Data Science, Juni 2025.)
Manifold Hypothesis: High-dimensional data lies on or near a low-dimensional structure called a manifold. Das ist die Annahme hinter allem, was wir über latente Räume gesagt haben: Der Autoencoder findet die Parametrisierung der Mannigfaltigkeit, der VAE glättet sie, word2vec legt Wörter auf eine Mannigfaltigkeit, auf der Richtungen Bedeutung haben.
Problems with the Manifold Hypothesis: Sometimes data does not have a low-dimensional structure and cannot be effectively mapped onto a lower-dimensional space – wegen Rauschen oder wegen zu weniger Samples, sodass die zugrundeliegende Struktur nicht geschätzt werden kann. Und manchmal ist die Struktur zwar niedrigdimensional, aber keine Mannigfaltigkeit: Zwei Kurven, die sich kreuzen, haben am Schnittpunkt keine eindeutige Tangente.
Genau das passiert bei Polysemie: Ein Wort wie „Maus“ (Tier, Computermaus) oder „Bank“ (Sitzgelegenheit, Geldinstitut) hat mehrere Bedeutungen, die in verschiedenen Kontexten vorkommen. Im Embedding-Raum eines kontextabhängigen Modells (BERT) liegen die Vorkommen von „Maus“ auf mehreren „Ästen“, die sich an einem Punkt treffen – eine Singularität der Datenmannigfaltigkeit. Topologische Datenanalyse (persistent homology, lokale Dimension) kann solche Singularitäten finden und damit polyseme Wörter ohne Wörterbuch aus den Embeddings entdecken. word2vec mit einem Vektor pro Wort kann das prinzipiell nicht: Es muss alle Bedeutungen in einen Punkt mitteln.
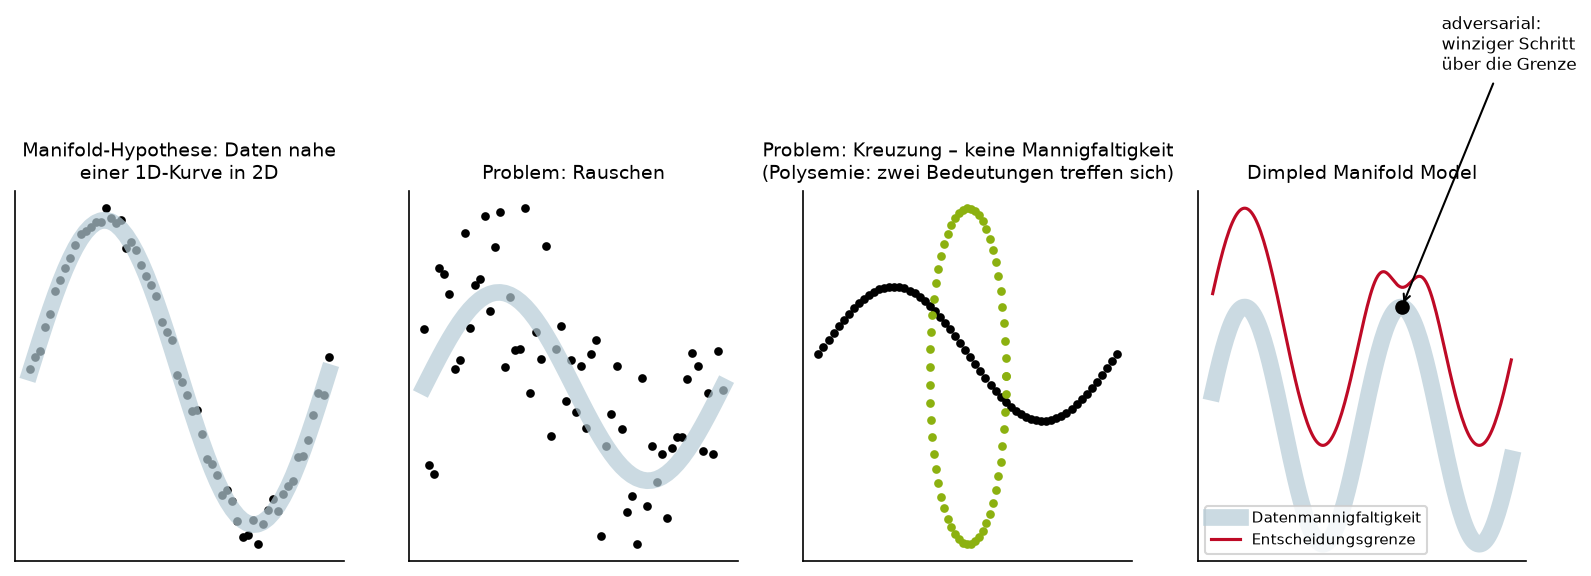
Die Manifold-Hypothese und ihre Grenzen: Daten nahe einer Kurve; Rauschen; zwei sich kreuzende Kurven (keine Mannigfaltigkeit – so sieht Polysemie im Embedding-Raum aus); und das Dimpled Manifold Model, in dem die Entscheidungsgrenze sich an die Daten schmiegt und Adversarial Examples nur einen winzigen Schritt entfernt sind.
Damit schließt sich der Kreis zur Kernfrage aus dem Kapitel „Latente Räume geometrisch“: Welche Struktur finden wir im Latent Space? Manchmal eine schöne Mannigfaltigkeit – und manchmal etwas Interessanteres.
Übung
Ein Bildausschnitt , der Gradient des Loss nach sei , und .
Berechnen Sie .
Wie groß ist die größte Änderung eines einzelnen Pixels? Wie groß ist sie in 8-Bit-Stufen (also mal 255)? Tipp: Genau deshalb sieht man die Störung nicht.
Warum benutzt FGSM nur das Vorzeichen des Gradienten und nicht seinen Betrag?
Antwortprobe: Alle drei Pixel ändern sich um denselben Betrag.