Autoencoder, VAE, word2vec, GANs – alle diese Modelle haben einen latenten Raum, in dem die gelernten Repräsentationen leben. In diesem Kapitel geht es um die Geometrie dieser Räume: Was bedeuten Richtungen und Abstände, was passiert zwischen zwei Codes, und was unterscheidet den diskreten latenten Raum eines Sprachmodells vom kontinuierlichen eines Bild-Autoencoders?
Wortvektoren geometrisch verstehen
Arithmetik im Latent Space
Der Klassiker bei word2vec: . Also ist die Richtung „feminin“. Auch:
(also die Richtung „Hauptstadt“),
(also die Richtung „Vergangenheit“),
(also Steigerung der Intensität als Richtung).
Analog, aber in allen LLMs: Semantische Beziehungen werden zu Richtungen im latenten Raum, und Richtungen kann man addieren. Das ist keine Eigenschaft, auf die word2vec trainiert wurde, sie entsteht von selbst aus dem Kontext-Vorhersage-Training.
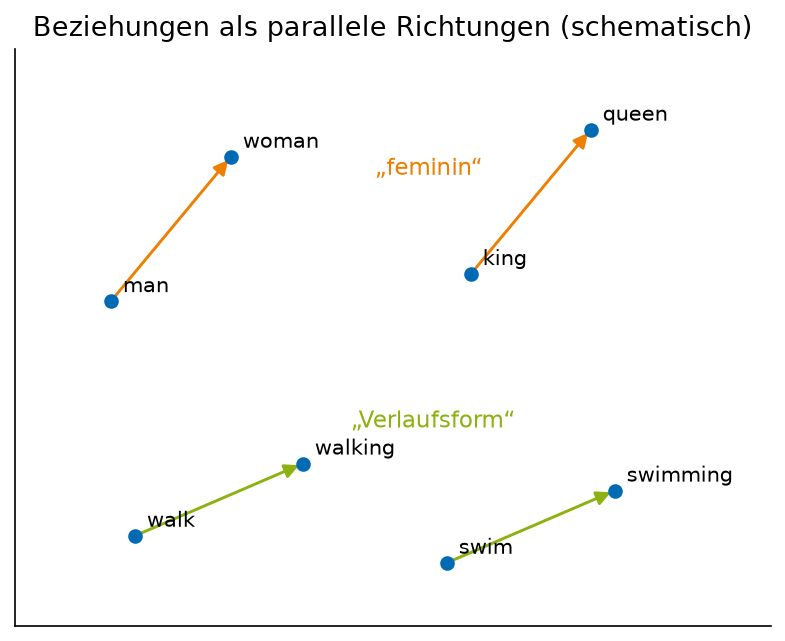
Beziehungen zwischen Wörtern als parallele Richtungen im Vektorraum (schematisch).
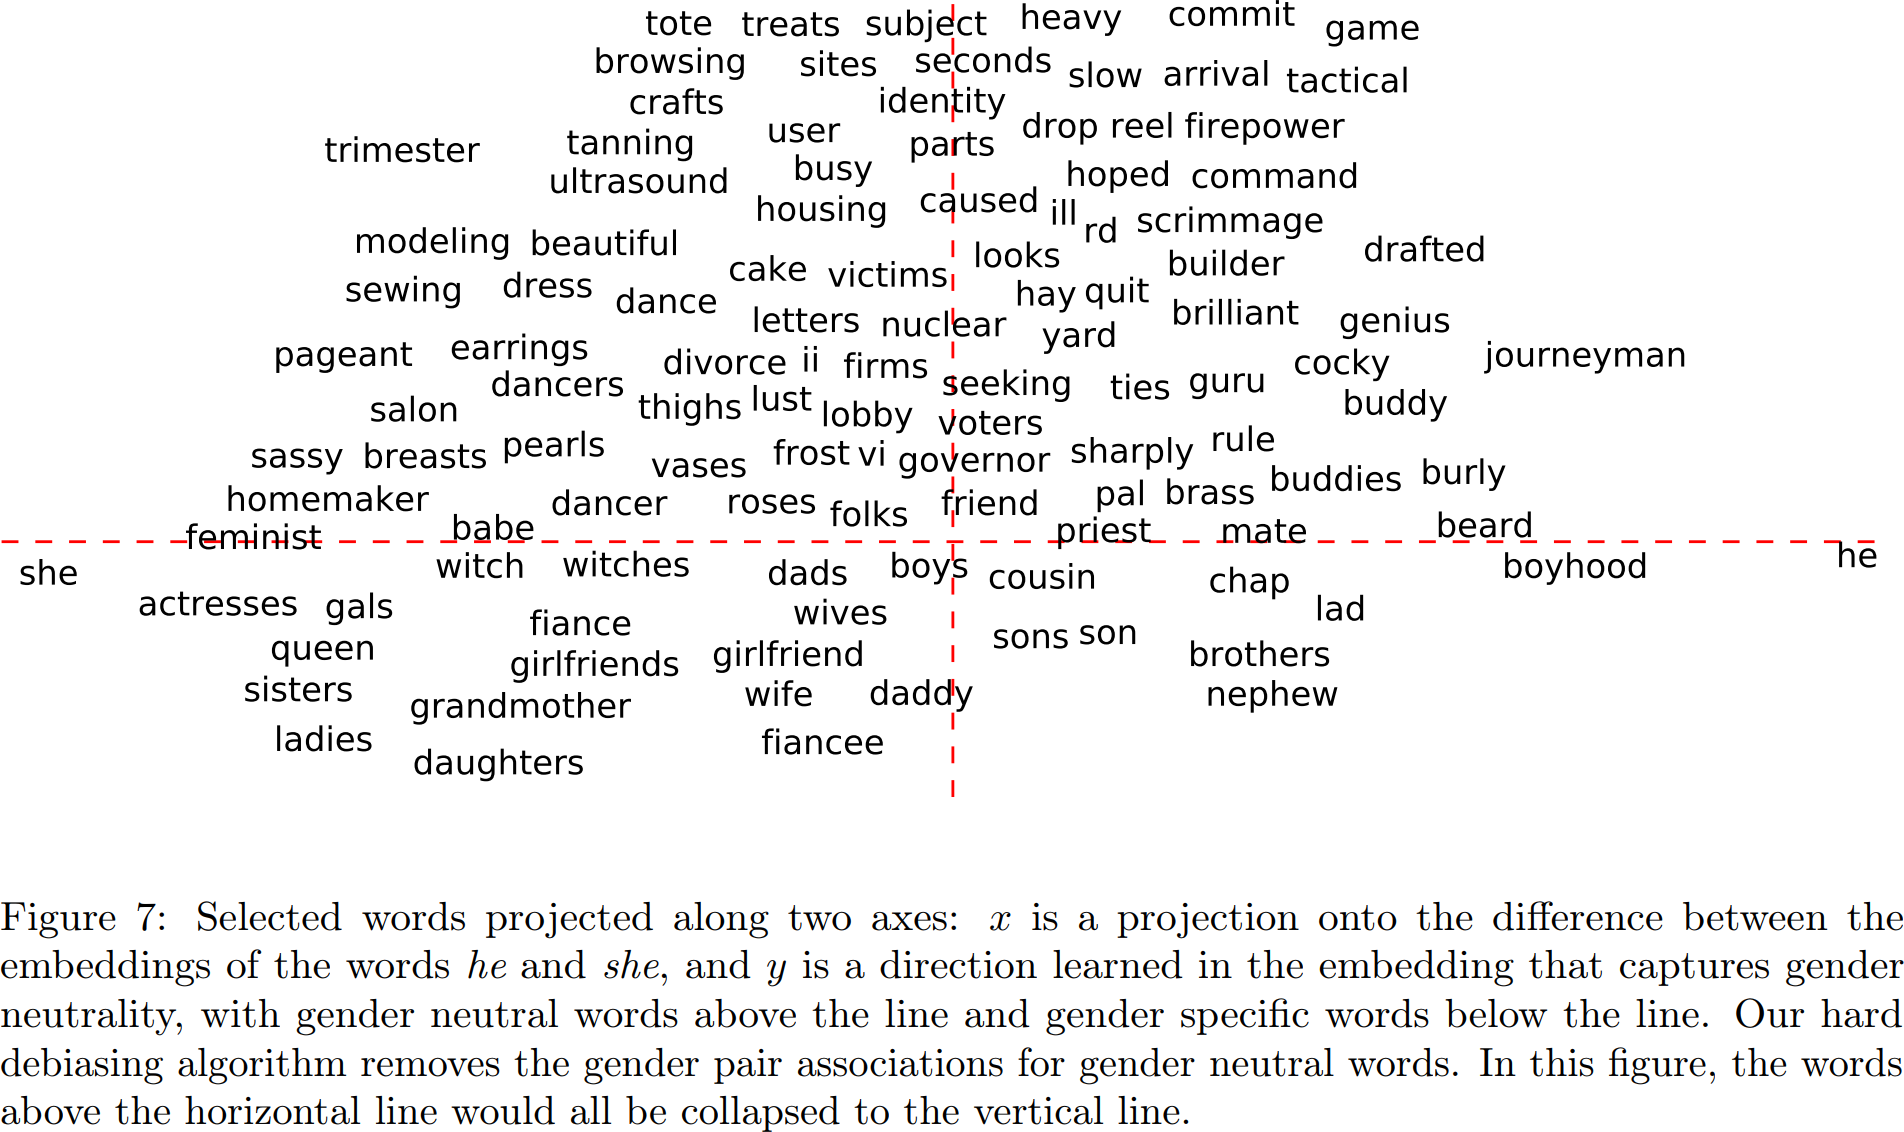
Figure 7 aus Bolukbasi et al. 2016 – Berufe, projiziert auf die Gender-Richtung.
Bolukbasi et al. 2016, Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings: Dieselbe Arithmetik findet auch . Die Embeddings enthalten die Stereotype des Trainingskorpus als Richtungen, und man kann sie messen – und, das ist der Beitrag des Papers, durch Projektion auf das orthogonale Komplement der Gender-Richtung teilweise entfernen (Abbildung oben).
Interpolation und Superposition
Ein Vektor im Latent Space ist ausdrucksstärker als ein Token, er kann interpolieren und Superposition ausdrücken: Statt „Katze“ oder „Hund“ geht auch oder auch . Aber: ist entweder Katze oder Hund, es gibt kein „dazwischen“-Token außerhalb des Vokabulars.
Diskreter Latent Space
Bei word2vec und LLMs mit einem Vokabular von Token können nur genau Vektoren im Latent Space direkt zu Token dekodiert werden; für jeden anderen Vektor werden nahe liegende solche Vektoren ausgewählt zum Dekodieren. Gegeben ein Vektor im Latent Space, welches Token wählen wir aus? Das ist die Sampling-Strategie.
Gegeben Vektor , welches Token Vokabular wählen wir?
Berechne für jedes den Abstand , z.B. im Kosinus-Abstand , und wähle , sodass dieser Abstand minimal wird (top-1, greedy decoding).
Betrachte auf allen Token die Verteilung und sample aus dieser Verteilung.
Für eine natürliche Zahl (z.B. ) wähle die nächstgelegenen Token aus und sample mit der Softmax-Verteilung nur aus (top-k sampling; top-p nimmt stattdessen so viele Token, bis ihre Wahrscheinlichkeit überschreitet).
Verändere die Verteilung: Richtung top-1 durch niedrige Temperatur, Richtung Gleichverteilung durch hohe Temperatur.
Temperature Scaling: Gegeben eine Temperatur , berechne die Verteilung
d.h. die Einträge von (die Logits) werden durch geteilt, dann wird mit Softmax eine Wahrscheinlichkeitsverteilung daraus. Großes : Die verschiedenen werden sich ähnlicher, das Modell wird „kreativer“ (und fehleranfälliger). Kleines : Die großen werden größer, die kleinen werden kleiner; im Grenzfall ist es top-1.
Latente Räume für Bilder: AE, VAE, GAN
Erinnerung: kontinuierlich statt diskret
Bei word2vec und LLMs können nur Vektoren dekodiert werden. Bei Autoencodern für Bilder ist dies anders: Jeder Vektor im Latent Space lässt sich zu einem Bild dekodieren. Damit lässt sich z.B. zwischen Hund und Katze interpolieren – der Decoder produziert für tatsächlich ein Bild, ob es sinnvoll aussieht, ist eine andere Frage.
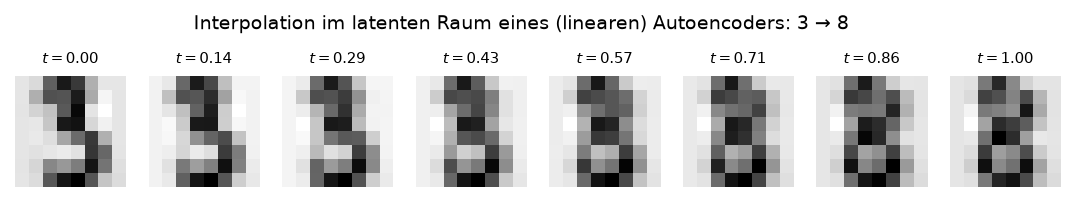
Lineare Interpolation zwischen den Codes einer 3 und einer 8 im latenten Raum eines linearen Autoencoders (PCA mit 16 Komponenten auf den 8×8-Ziffern aus scikit-learn): Jeder Zwischenpunkt ist ein Bild.
Autoencoder vs. GANs
Der Generator eines GANs ist typischerweise gegeben durch eine Verteilung auf einem Latent Space, aus der gesampelt wird (i.d.R. eine Standardnormalverteilung), und einen Decoder, der aus dem latenten Vektor ein tatsächliches Bild generiert. Um einen guten Decoder zu bekommen, ist vor dem adversarial Training ein Pretraining in einem Autoencoder-Setup sinnvoll; daher ist der Latent Space zunächst derselbe. Nach dem GAN-Training des Decoders passen Encoder und Decoder aber nicht mehr zusammen, d.h. der Rekonstruktions-Loss steigt, während der Adversarial Loss sinkt. Der GAN-Decoder optimiert „sieht echt aus“, nicht „ist das Original“.
Autoencoder vs. VAE
Der Encoder eines VAE kodiert ein Eingabebild als Paar , wobei ein latenter Vektor wie beim Autoencoder ist. Der Unterschied vom VAE zum AE liegt im Training: Statt mit zu vergleichen, wird mit verglichen, wobei Varianz hat. Nach erfolgreichem Training ist dann auch , aber der Latent Space bzw. Decoder sieht anders aus als beim AE: Um jeden Code herum gibt es eine Umgebung, die ebenfalls zu einem ähnlichen Bild dekodiert.
Häufig wird zusätzlich zum -Trick auch noch ein Summand zur Loss-Funktion hinzugefügt, damit die Codes der Trainingsdaten im Latent Space ungefähr standardnormalverteilt sind (Variational Loss, siehe Kapitel „Variational Autoencoder“). So kann man später aus der Standardnormalverteilung im Latent Space sampeln und bleibt in der gelernten Verteilung.
Arvanitidis et al. 2017: Latent Space Oddity
Latent Space Oddity: on the Curvature of Deep Generative Models (ICLR 2018): Der latente Raum eines VAE sieht flach aus, aber der Decoder verzerrt ihn – die euklidische Gerade zwischen zwei Codes ist nicht der kürzeste Weg im Bildraum. Die richtige Geometrie ist die durch den Decoder induzierte Riemannsche Metrik, und Geodäten darin laufen um Regionen herum, in denen der Decoder unsicher ist (Abbildung unten). Praktisch: Interpolationen entlang Geodäten sehen besser aus als lineare.
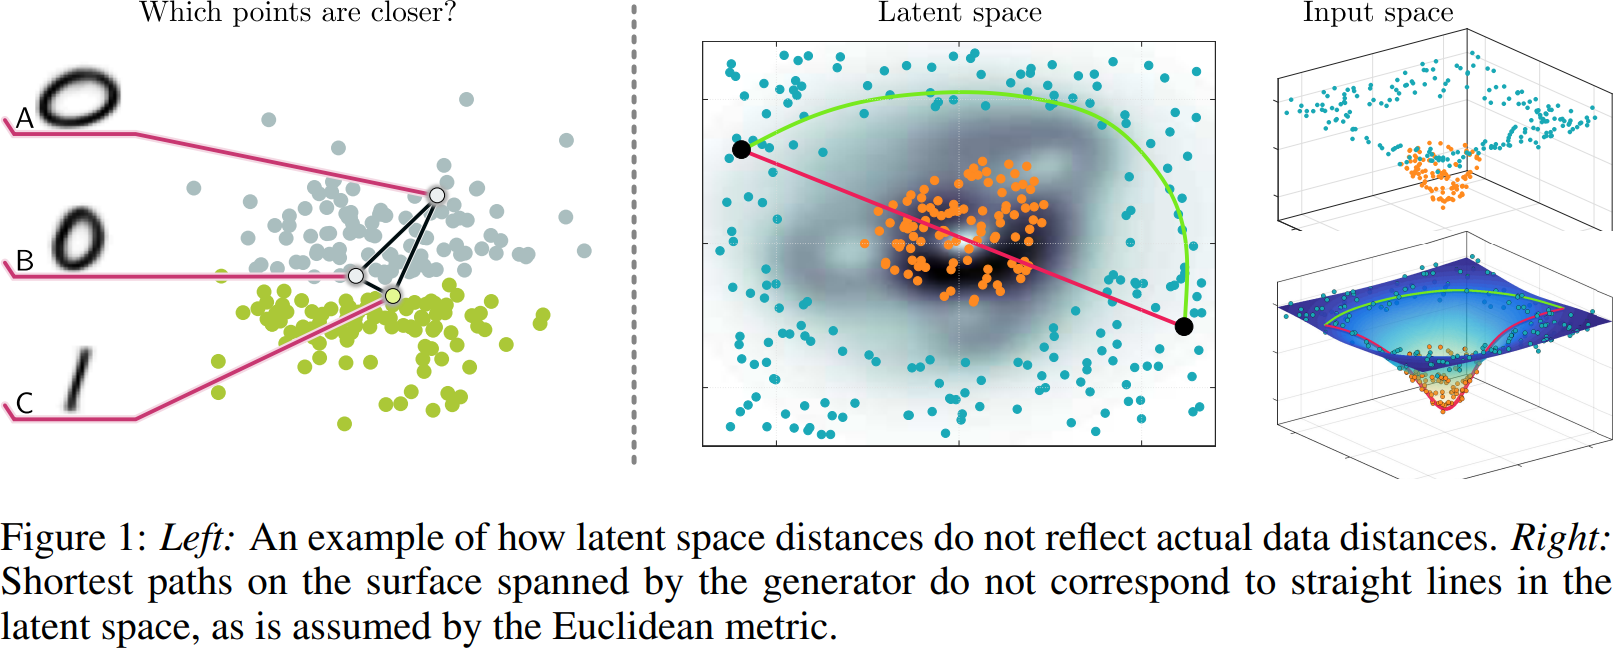
Figure 1 aus Arvanitidis, Hansen, Hauberg: Latent Space Oddity (ICLR 2018): Die Gerade im latenten Raum (links) und die Geodäte bezüglich der vom Decoder induzierten Metrik führen zu unterschiedlichen Interpolationen.
Übung
Gegeben Embeddings , , .
Berechnen Sie . Welcher der Vektoren , , liegt am nächsten – gemessen mit dem Kosinus? Tipp: Kosinus heißt: normieren, dann Skalarprodukt. Die Längen unterscheiden sich hier deutlich, das Ergebnis mit euklidischem Abstand wäre ein anderes.
Interpolieren Sie linear zwischen und in drei Schritten.
Antwortprobe: Bei (1) sind die Antworten für Kosinus und euklidischen Abstand verschieden – das ist der Punkt der Aufgabe.