Aktivierungsfunktionen und weitere Layer
Ein Neuron „forward“ ist . Beim Perzeptron ist , bei der logistischen Regression . Allgemein ist beliebig – aber ableitbar, sonst funktioniert Backpropagation nicht. Überall differenzierbar muss es dafür nicht sein: ReLU hat bei 0 einen Knick und ist trotzdem die meistbenutzte Aktivierungsfunktion überhaupt. Wie das zusammengeht, klärt der nächste Abschnitt.
Neues Ziel: Funktionen lernen
Bisher war das Ziel Klassifikation. Neues Ziel: Das neuronale Netz soll eine Funktion lernen (Regression), und unser Modell von der Funktion ist stückweise linear. Welches ist dafür geeignet?
Ableitung von nach : Für ist , also ist die Ableitung 1. Für ist , also ist die Ableitung 0. Für ist die Ableitung nicht definiert – wir definieren sie als 0, das spart Rechnungen. (Dass das erlaubt ist, steckt im Begriff der schwachen Ableitung: Sie darf an einzelnen Punkten beliebig sein.)
Wieso ist ReLU geeignet? Lineare Abbildung + ReLU ist die Projektion auf einen Halbraum, denn ReLU ist genau die Projektion von auf , und ein Halbraum ist eine Seite einer Hyperebene. Ein ReLU-Neuron ist also null auf der einen Seite der Hyperebene und linear ansteigend auf der anderen. Summiert man mehrere solche „Knickfunktionen“ mit Gewichten, bekommt man stückweise lineare Funktionen, deren Knickstellen auf den Hyperebenen liegen – und mit genug Neuronen kann man damit jede stetige Funktion beliebig gut approximieren. Beispiel an der Tafel; im Kapitel „Netze von Hand bauen“ bauen wir so .
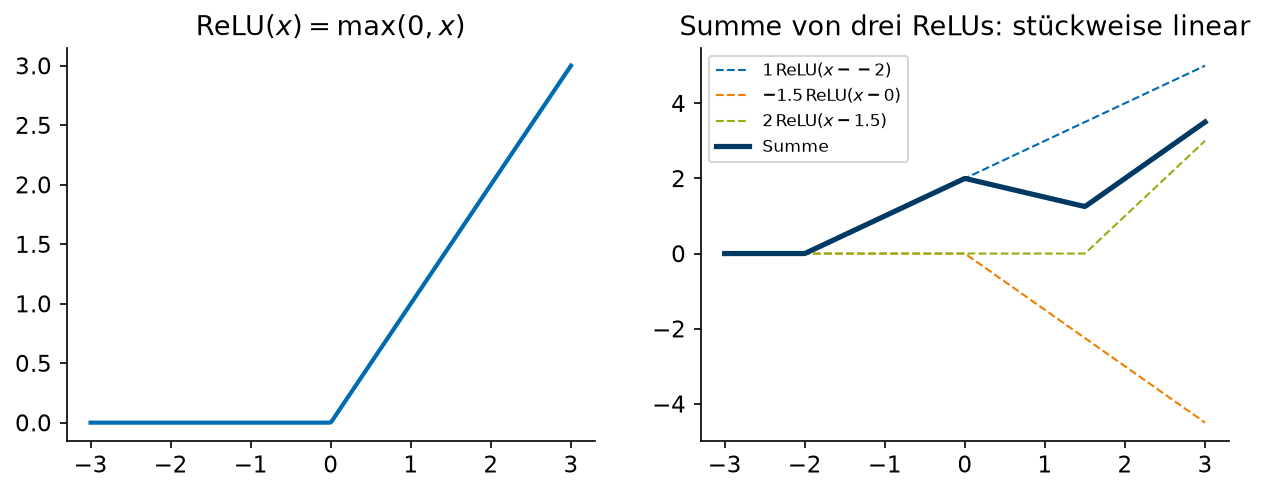
Links die ReLU, rechts eine gewichtete Summe von drei verschobenen ReLUs: eine stückweise lineare Funktion mit Knicken an den Verschiebungen.
Layer, nochmal
Mehrere Neuronen, die parallel verarbeitet werden, bilden eine Schicht. Ein Linear Layer ist eine Matrix (Zeilen = Gewichtsvektoren) plus Bias. Ein ReLU Layer ist eine Schicht, in der jedes Neuron die Aktivierungsfunktion ReLU nutzt, also Linear Layer + komponentenweises ReLU. In PyTorch: nn.Sequential(nn.Linear(n, m), nn.ReLU()).
Problem bei ReLU: sterbende Neuronen
Wenn ein Neuron immer 0 liefert, weil die Eingabe immer negativ ist, „fließt“ keine Information mehr durch das Neuron während der Backpropagation – die Ableitung ist 0, also ist für dieses Neuron 0, also ändern sich seine Gewichte nie wieder. Das Neuron ist tot. Zwei Lösungen:
Lösung 1: Statt verwende mit passenden , sodass auch für die Ableitung nicht null ist. Mit und heißt ELU (Exponential Linear Unit); mit heißt es Leaky ReLU.
Lösung 2: Statt verwende ein glattes , sodass für gilt und für gilt , aber ohne harten Knick:
wobei die Verteilungsfunktion der Standardnormalverteilung ist. Beide sind im negativen Bereich nicht strikt null, sondern haben eine kleine Delle unter der Achse, und die Ableitung verschwindet nur asymptotisch. GELU steht in den Transformern der BERT- und GPT-2-Generation und in Vision Transformern; die heutigen großen Sprachmodelle (Llama, Mistral, Qwen) nehmen stattdessen Swish/SiLU, eingebaut in einen gated Feed-Forward-Block, den man SwiGLU nennt.
Welche Aktivierungsfunktionen in der Praxis genutzt wurden, listete paperswithcode – die Seite gibt es nicht mehr, der Link führt auf den Schnappschuss vom Juli 2025 im Internet Archive.
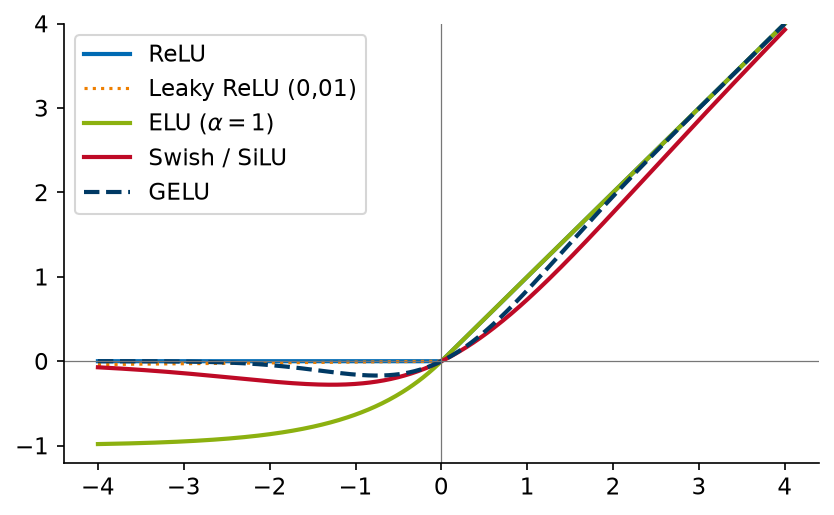
Aktivierungsfunktionen im Vergleich. ELU, Swish und GELU sind im negativen Bereich nicht konstant null.
Übung
Ein Neuron mit und sieht nur Trainingsdaten mit nichtnegativen Einträgen.
Zeigen Sie: Die Ausgabe ist für alle diese Daten 0.
Welchen Wert hat der Gradient nach und dann? Was folgt daraus für das Training?
Antwortprobe: Bei (2) ist die Antwort für und dieselbe.