Vom Autoencoder zum VAE
Motivation: probabilistische Modelle
Beim klassischen Autoencoder bildet der Encoder einen Datenpunkt aus dem Datenraum auf einen Punkt im latenten Raum ab, der Decoder einen Punkt zurück in den Datenraum ( und sind dieselben Dimensionen wie im Kapitel „Autoencoder“); Ziel ist möglichst klein. Die Modellannahme war aber: Die Punkte sind eine Stichprobe aus einer Verteilung. Können wir die Verteilung direkt mit modellieren, in ?
Variation des Ziels: Auch soll möglichst klein sein, für einen normalverteilten Fehler . Variation des Trainings: Nach ein sampeln, addieren, dann . Der Decoder muss dann nicht nur den Punkt , sondern eine ganze Umgebung davon auf abbilden – der latente Raum wird „glatt“.
Oh: Wie geht Backpropagation für „ein sampeln“? Da nicht von den Gewichten abhängt, ganz normal mit der Kettenregel:
Das gesampelte ist im Rückwärtsdurchlauf einfach eine Konstante.
Beispiel im latenten Raum. Mit 3 Datenpunkten: Klassisch sind das 3 Punkte. Mit werden es 3 Wolken gleicher Größe. Mit für einen Skalierungsfaktor kann man die Wolkengröße steuern. (In diesem Kapitel ist durchgehend eine Streuung, nicht die logistische Sigmoidfunktion aus dem Kapitel „Logistische Regression“.) Mit 300 Datenpunkten: Klassisch eine Punktwolke mit Löchern und Ausreißern; gut wäre eine Verteilung, die den latenten Raum lückenlos und gleichmäßig füllt, sodass man an jeder Stelle dekodieren kann.
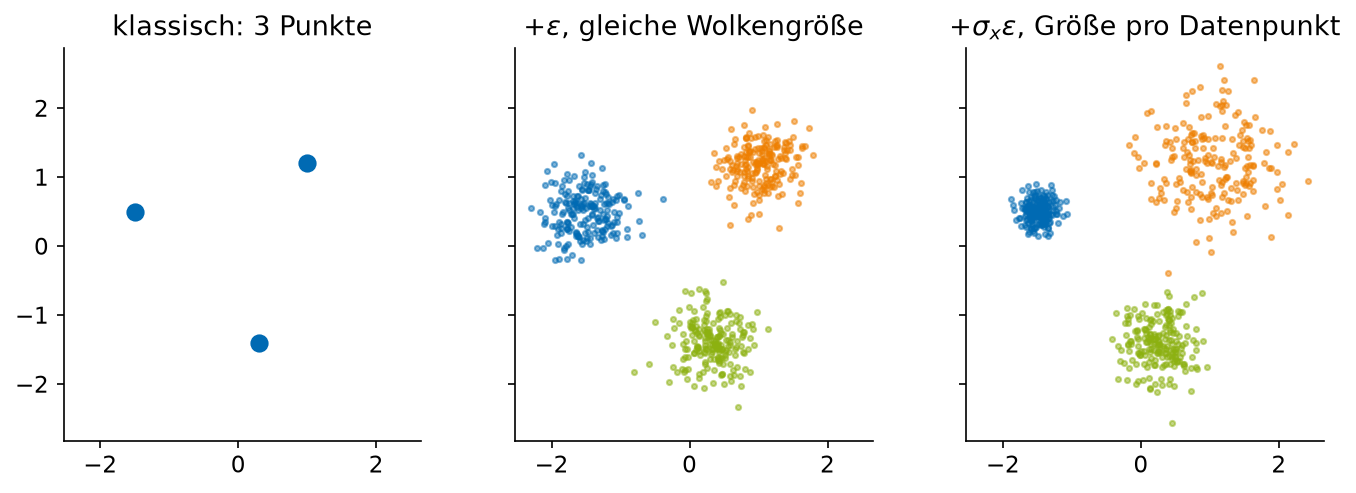
Drei Datenpunkte im latenten Raum – klassisch, mit gleichem Rauschen , mit datenabhängigem Rauschen .
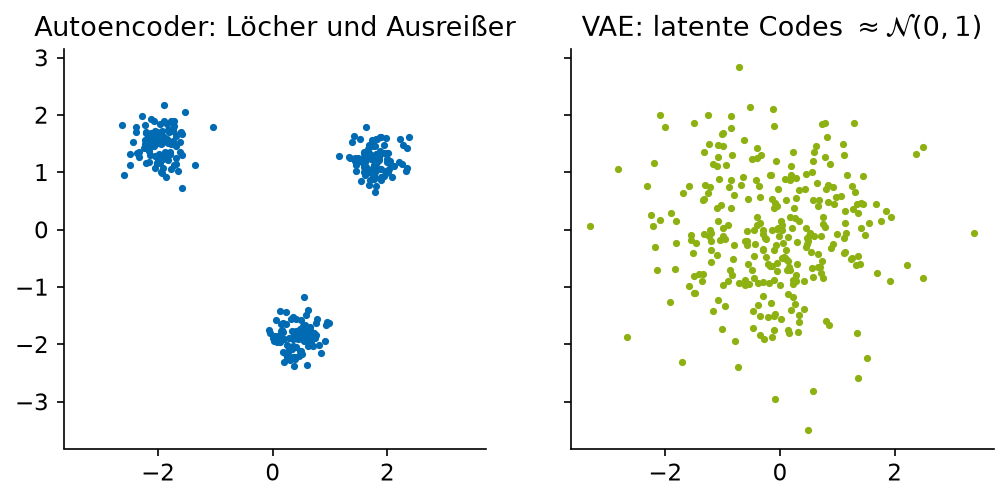
300 Datenpunkte – ein klassischer Autoencoder lässt Löcher und Ausreißer, ein VAE zieht die Codes zur Standardnormalverteilung.
Modelliere die Verteilung also mit einer gaußschen Mischung im latenten Raum, in der die Störung von den Daten abhängt: Zu jedem Datenpunkt brauchen wir zusätzlich zu auch eine Standardabweichung (bzw. besser noch eine Kovarianzmatrix ), dann mit . Aber Sampling aus einer Verteilung, deren Parameter von den Gewichten abhängen, lässt sich nicht ableiten. Reparametrisierungstrick: statt besser
denn dann ist wieder eine Konstante und ein ganz normaler Ausgang des Encoders, durch den Gradienten fließen.
Training
Wie trainiert man einen Variational Autoencoder? Für jeden Datenpunkt berechne – der Encoder hat jetzt Ausgänge –, generiere ein und setze . Die Loss-Funktion ist naiv . Das hat einen Haken, und zwar in beide Richtungen: Das Netz kann lernen und ist dann wieder ein klassischer Autoencoder. Oder es lässt und beliebig groß werden, dann explodieren die latenten Vektoren, die Wolken der einzelnen Datenpunkte liegen weit auseinander, und der latente Raum füllt sich nie lückenlos.
Stabileres Training mit dem Extra-Term Variational Loss:
wobei die Dichte der latenten Verteilung für ein festes ist. Dabei sind die beiden Standardnormalverteilungen – das für und das im KL-Term – nicht „dieselben“!! Die erste ist die Rauschquelle, die zweite ist die Prior-Verteilung, an die sich die Gesamtheit der latenten Verteilungen anschmiegen soll, damit der latente Raum um den Ursprung herum lückenlos gefüllt ist. In der Praxis lässt man den Encoder statt den Logarithmus der Varianz ausgeben, (im Code meist logvar), damit kein Ausgang auf positive Werte eingeschränkt werden muss; dann ist . Für Normalverteilungen hat der KL-Term eine geschlossene Form:
Diese Loss-Funktion ist der negative ELBO (evidence lower bound) aus dem Kapitel Expectation Maximization in Data Science – bis auf einen Faktor und eine additive Konstante, die daher rühren, dass wir den Rekonstruktionsterm als schlichten MSE schreiben statt als negative Log-Likelihood eines gaußschen Decoders mit fester Varianz. Für die Optimierung macht das keinen Unterschied, für den Vergleich der Zahlenwerte schon.
Recap
Ein VAE ist ein Autoencoder, dessen Encoder statt eines Punkts eine Normalverteilung im latenten Raum ausgibt, dessen Decoder aus einer Stichprobe daraus rekonstruiert, und dessen Loss die Rekonstruktion plus die KL-Divergenz zum Standardnormal-Prior ist. Danach kann man neue Daten generieren, indem man sampelt und dekodiert. Schön zusammengefasst in Lilian Wengs Blogpost From Autoencoder to Beta-VAE. VAEs sind heute noch eine Komponente der Bildgeneratoren (DALL-E, Midjourney, Stable Diffusion): Die Diffusion findet im latenten Raum eines VAE statt.
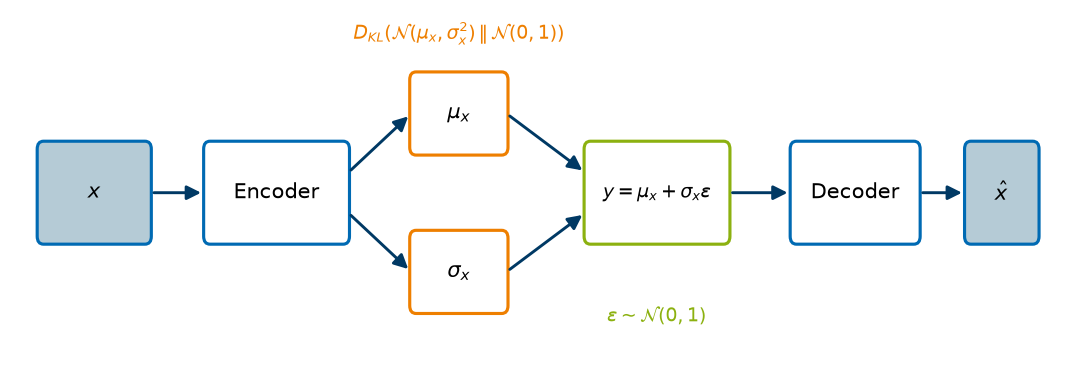
Der Variational Autoencoder mit Reparametrisierungstrick: Der Encoder liefert und , das Rauschen ist eine Konstante für die Backpropagation, der KL-Term zieht die Codes zum Prior.
Übung
Der variational loss term für eine latente Dimension ist .
Für welches Paar wird er null? Rechnen Sie nach, dass er dort ein Minimum hat. Tipp: Leiten Sie nach und nach getrennt ab.
Berechnen Sie den Wert für und für . Welche der beiden Abweichungen bestraft der Term stärker?
Der Reparametrisierungstrick schreibt mit . Warum lässt sich ohne ihn nicht nach und ableiten?
Antwortprobe: Bei (2) ist genau ein Wert größer als 1.