word2vec
Von der Anwendung her gedacht
Ein Beispiel-Task, unsupervised mit neuronalen Netzen: Alle Dokumente einlesen als Liste von Wörtern (getrennt an Leerzeichen, Satzzeichen entfernt), dann jedes einzelne Wort mit einem zuvor trainierten neuronalen Netz umrechnen in eine andere Repräsentation, die sich besser vergleichen lässt. Die andere Repräsentation verschaffen wir uns durch latente Vektoren aus einem Autoencoder. Das ist die Idee von word2vec (Mikolov et al., Google, 2013).
Vorverarbeitung und Ziel
Wir zählen alle Wörter (bzw. Token) im Korpus,
entfernen Stopwords und sortieren nach Häufigkeit,
behalten die häufigsten Wörter (z.B. ),
kodieren diese mit One-Hot-Encoding als Vektoren in ,
mit dem Ziel, eine Abbildung zu finden, (z.B. ),
mit einer „Decoder“-Abbildung , sodass für alle Wörter unserer Liste gilt,
und semantisch ähnliche Wörter nach Kodieren in einen kleinen Abstand haben.
Punkt 6 allein wäre ein gewöhnlicher Autoencoder auf One-Hot-Vektoren – und der lernt nichts über Bedeutung, denn One-Hot-Vektoren sind alle gleich weit voneinander entfernt. Punkt 7 ist der Clou.
Kernidee
Die Semantik eines Wortes ergibt sich durch seine Nutzung in Sätzen (distributional hypothesis). Beispiel: „Die [MASK] frisst ihr Futter am liebsten aus dem goldenen Napf“ kommt in Texten mit [MASK] = Katze und [MASK] = Hündin vor. Der Machine-Learning-Task, unsupervised: Gegeben Text, ersetze ein Wort durch [MASK] und lasse vorhersagen, was [MASK] ist – wie ein Denoising Autoencoder, bei dem das Rauschen im Löschen eines Wortes besteht.
CBOW (Continuous Bag of Words, für kleinere Korpora). Hyperparameter ist die Fenstergröße (window size), z.B. . Eingabe: Token, die hintereinander im Text vorkommen, dabei das mittlere durch [MASK] ersetzt – also One-Hot-Vektoren. Ausgabe: eine Wahrscheinlichkeitsverteilung auf allen Wörtern. Loss-Funktion: negative Log-Likelihood (NLL), d.h. Vergleich der ausgegebenen Verteilung mit dem One-Hot-Vektor für das Wort, welches sich hinter [MASK] verbirgt. Architektur: 1 Hidden Layer mit Neuronen, der „Encoder“ , angewendet auf alle Kontextwörter und dann gemittelt (averaging), danach ein Layer „Decoder“ gefolgt von Softmax:
Die Wortvektoren sind die Spalten von : ist für einen One-Hot-Vektor einfach die entsprechende Spalte.
Skip-gram, die Alternative zu CBOW: Gegeben ein Token, sage den Kontext vorher. Eingabe: das mittlere Token als One-Hot-Vektor für eine Abfolge von Token. Ausgabe: eine Wahrscheinlichkeitsverteilung auf allen Token. Loss-Funktion: NLL, d.h. Vergleich der ausgegebenen Verteilung mit der Summe der One-Hot-Vektoren für alle Kontexttoken. Architektur: 1 Hidden Linear Layer mit Neuronen (der „Encoder“), danach ein Layer „Decoder“ mit Neuronen gefolgt von Softmax. Skip-gram funktioniert bei großen Korpora und seltenen Wörtern besser.
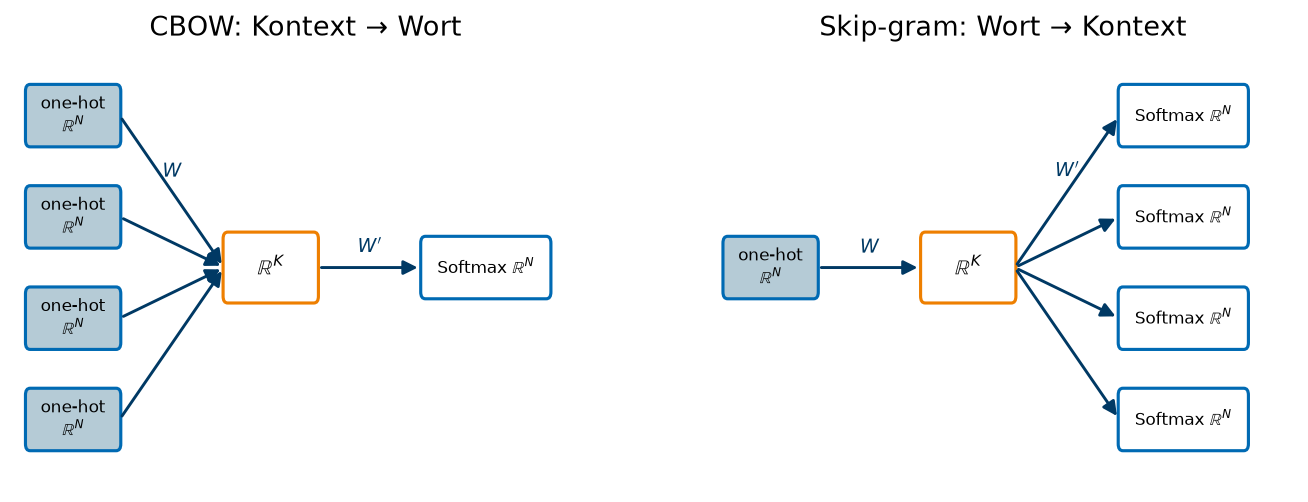
CBOW und Skip-gram: dieselben zwei Matrizen (Encoder, ) und (Decoder, ), einmal von mehreren Kontextwörtern auf ein Wort, einmal umgekehrt.
word2vec benutzen
Verfügbare Gewichte gibt es mit Gensim (z.B. wiki-english-20171001) oder von Hugging Face (z.B. word2vec
word2vec selbst trainieren (ein ganz knapper Überblick)
Zutatenliste: Keine GPU oder andere Beschleuniger zur Hand? Google Colab oder CPU reicht. Input: ein Textkorpus zum Training, eine Tokenization-Strategie bzw. ein Tokenizer (darüber sprechen wir noch), die Dimension des Latent Space, CBOW oder Skip-gram (wie groß ist das Korpus?), von Grund auf trainieren (Pretraining) oder Finetuning, und welche Implementierung?
Gensim (Tutorial). Pro: NLP-Gesamtlösung, gut dokumentiertes Paket. Contra: keine GPU-Beschleunigung (aber für word2vec ist das „egal“), und keine Kombination von word2vec im Training mit anderen Tasks (wie wir es beim Denoising Label Autoencoder getan haben).
PyTorch, „so richtig von Hand“: Skip-gram implementation step by step; oder mit dem
torch.nn.Embedding-Layer (das ist die Matrix , allerdings transponiert gespeichert:nn.Embedding(N, K).weighthat Shape(N, K), eine Zeile pro Wort, und die Multiplikation mit dem One-Hot-Vektor ist als Lookup implementiert): Word Embeddings: Encoding Lexical Semantics, d2l.ai.
Wozu? Durch Pretraining oder Finetuning von word2vec-Modellen mit PyTorch bekommt man Wortvektoren, die auf die eigene Domäne (Fachsprache, andere Sprache) passen, und kann sie als erste Schicht in ein größeres Modell einbauen.
Von Wörtern zu Dokumenten: NLP
Beispiel-Task: ähnliche Dokumente finden
Gegeben ist eine Menge von (kurzen) Dokumenten (z.B. Tweets, Webseiten, Hausarbeiten). Gesucht sind Paare ähnlicher Dokumente (), z.B. um Tweets thematisch zu gruppieren oder Plagiate zu finden: , Paare von Indizes, sodass und ähnlich sind.
Klassischer Ansatz: Wörter in zählen, Häufigkeitsverteilungen von und vergleichen (bag of words). Probleme mit diesem Ansatz:
„Katze isst Maus“ und „Maus isst Katze“ sind ununterscheidbar.
„Schwimmen“ und „schwamm“ haben nichts miteinander zu tun.
„Hund“ und „Tier“ haben nichts miteinander zu tun.
Wörter wie „der“, „die“, „das“ sind sehr häufig, aber bedeutungslos.
Klassische Lösungsansätze: (1) -Gramme statt Wörter betrachten, (2) Lemmatisierung, (3) komplexe Ontologien (formalisiertes Wissen), (4) Stopwords entfernen.
Wörter? Token!
Alternative Lösung zu Problem 2 (statt Lemmatisierung): Buchstaben bzw. Zeichen anstelle von Wörtern als „Atome“ (= Token) nehmen, und -Gramme davon (z.B. Trigramme, ). Beispiel: „schwimm!“ und „schwimmen“ ergeben
die haben sehr ähnliche Trigrammhäufigkeitsverteilungen. Konkret zu klärende Fragen: Leerzeichen wie jedes andere Zeichen behandeln? Über das Satzende „.“ hinaus? Flexibles , z.B. Silben statt Buchstabentrigramme? Die Antworten darauf bilden die Tokenisierungsstrategie, den Tokenizer. Der Einfachheit halber bleiben wir zunächst bei Token = Wörter, d.h. wir löschen Satzzeichen und trennen an Leerzeichen; Byte Pair Encoding, der Tokenizer moderner LLMs, kommt im Kapitel „Transformer“.
Modernerer Ansatz (supervised): mit einem neuronalen Netz; Menschen labeln Ähnlichkeit. Eingabe: Paare , Ausgabe: Ähnlichkeitsschätzung. Unsupervised mit neuronalen Netzen:
Alle Dokumente einlesen als Liste von Wörtern.
Jedes einzelne Wort mit einem zuvor trainierten neuronalen Netz (word2vec) umrechnen in eine andere Repräsentation, die sich besser vergleichen lässt.
Für jedes Paar die Listen von Repräsentationen vergleichen (z.B. Kosinus-Ähnlichkeit der Mittelwerte), daraus ein Ähnlichkeitsmaß für das Paar berechnen.
Die Top- ähnlichsten Paare ausgeben.
Problem 3 („Hund“ und „Tier“) löst word2vec, weil beide in ähnlichen Kontexten vorkommen und daher nahe beieinander liegen. Problem 1 (Wortreihenfolge) löst es nicht – dafür braucht man Modelle, die Sequenzen verarbeiten (Kapitel „Recurrent Neural Networks“ und „Transformer“).
Literatur und Softwarepakete
Das modernste Lehrbuch ist Dan Jurafsky, James H. Martin: Speech and Language Processing. Es gibt einen „Third Edition Draft“ frei verfügbar: web
.stanford .edu / ~jurafsky /slp3/. Das Python Natural Language Toolkit (NLTK), nltk.org/book, enthält z.B. den PunktTokenizer, der so arbeitet wie wir jetzt.
Radim Řehůřeks (& Koautoren) gensim-Bibliothek für Python, radimrehurek
.com /gensim.
Übung
Der Satz „der hund bellt laut im garten“ (6 Token), Fenstergröße .
Wie viele (Kontext, Zielwort)-Paare erzeugt Skip-gram daraus? Schreiben Sie die Paare für das Zielwort „bellt“ auf. Tipp: Am Satzanfang und -ende ist das Fenster kleiner.
Was ist bei CBOW Eingabe und was Ausgabe – und wie herum ist es bei Skip-gram?
Der Embedding-Layer für ein Vokabular von 50 000 Wörtern und 300 Dimensionen: Wie viele Parameter, und was steht in Zeile ?
Antwortprobe: Bei (1) liefern das erste und das letzte Token je zwei Paare, das dritte und das vierte je vier; bei (3) sind es 15 Millionen.