Recurrent Neural Networks
RNNs
Input: ein linearer Strom von Daten, z.B. Text, Audio, Video oder andere Zeitreihen. Output: irgendeine vektorielle oder skalare Größe, z.B. die Vorhersage des nächsten Wortes. Idee: Zum Zeitpunkt nicht nur die neuen Daten , sondern auch die Ergebnisse aus den Daten von verwenden, um zum Ergebnis zu kommen. Ein rekurrentes Neuron hat einen hidden state :
In der „entfalteten Perspektive“ (unrolled) ist ein RNN über Zeitschritte ein tiefes Netz mit Schichten, die sich alle dieselben Gewichte teilen. Backpropagation funktioniert dann ganz normal (backpropagation through time) – mit dem Problem, dass Gradienten über viele Zeitschritte hinweg exponentiell verschwinden oder explodieren, weil immer wieder mit multipliziert wird. Die Lösung dafür sind LSTMs.
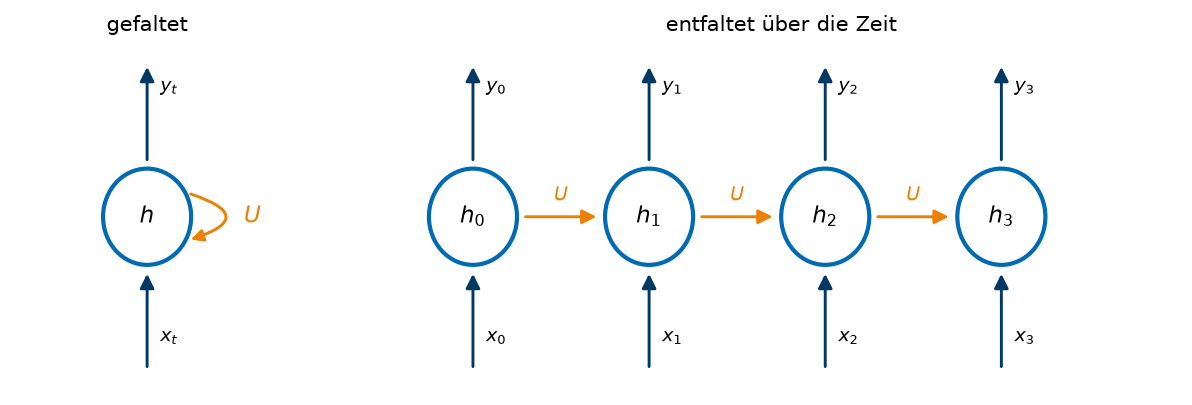
Ein rekurrentes Neuron: gefaltet mit der Rückkopplung (links) und über vier Zeitschritte entfaltet (rechts) – ein tiefes Netz mit geteilten Gewichten.
Historie: Rekurrente Netze
1982 Hopfield-Netzwerk · 1985 Boltzmann Machine (Hinton, Sejnowski) · 1980er RNNs · 1991 Schmidhubers frühe Attention · 1990er Gated RNNs · 1997 LSTM (Hochreiter, Schmidhuber) · 2014 GRUs (Cho, Bengio et al.) · 2017 Transformer (Vaswani et al.).
Im Gegensatz zur Finite Impulse Response (FIR) eines CNNs (machen wir noch) ist ein RNN ein Infinite Impulse Response (IIR) Signalverarbeiter: Ein Eingabesignal zum Zeitpunkt kann den Zustand prinzipiell für immer beeinflussen.
Trick: Skip Connections
Auch bekannt als Residual Connections. Anstatt (z.B. = MLP) parametrisiere
Idee: Jeder Layer ist nah dran an „nichts ändern“ (Identität), und der Gradient hat immer einen direkten Weg (den Term ) an der Schicht vorbei. Hilft gegen verschwindende oder explodierende Gradienten – in RNNs, in ResNets (daher der Name) und in Transformern.
Gated RNNs
GRU (Gated Recurrent Unit): Der hidden state ist gleichzeitig der Output. Aus Input und altem hidden state wird ein Kandidat für den neuen hidden state berechnet, und zwei Gates (Sigmoide, also Werte in ) steuern: Das Reset Gate, wie viel vom alten Zustand in den Kandidaten eingeht, und das Update Gate, wie stark der Zustand zum Kandidaten hin aktualisiert wird.
LSTM (Long Short-Term Memory): Zusätzlich zum hidden state (= Output, short term memory) gibt es einen cell state (long term memory), der nur durch Addition und komponentenweise Multiplikation verändert wird – eine Art Skip Connection durch die Zeit. Drei Gates (Sigmoide) steuern ihn: forget (was aus gelöscht wird), input (was neu hineingeschrieben wird), output (was davon in sichtbar wird). Mehr Erklärungen: Shi Yan @ MLReview, Understanding LSTM and its diagrams.
Schaltbilder der Zellen: LSTM und GRU auf Wikipedia (Abbildungen CC-BY-SA); die Gates sind dort als -Knoten gezeichnet, die elementweise multiplizieren, also genau die stetigen Bitmasken aus dem Kapitel „Netze von Hand bauen“.
Bill Gates (2018): „huge milestone in advancing artificial intelligence“ – weil OpenAI mit LSTMs Dota 2 gewann. Auch mit LSTMs gebaut: AlphaStar von Google DeepMind, spielt StarCraft 2 (2019).
LSTM praktisch
Mit PyTorch:
import torch.nn as nn

class MyModel(nn.Module):
    def __init__(self, embedding_length, hidden_size, output_size):
        super().__init__()
        self.lstm = nn.LSTM(embedding_length, hidden_size)
        self.label = nn.Linear(hidden_size, output_size)

    def forward(self, x):
        h, (h_n, c_n) = self.lstm(x)
        return self.label(h)
nn.LSTM bekommt eine Sequenz von Vektoren (z.B. word2vec-Embeddings der Wörter) und liefert die Sequenz der hidden states; darauf ein linearer Layer für die Vorhersage. Achtung bei den Achsen: Anders als sonst in PyTorch erwartet nn.LSTM voreingestellt (seq, batch, feature), der Batch liegt also auf der zweiten Achse (siehe Kapitel „Tensoren“). Mit batch_first=True im Konstruktor gilt wieder die gewohnte Reihenfolge.
Am Rande: Konkatenieren vs. Summe
Wenn wir zwei verschiedene Eingabevektoren in einer Schicht verarbeiten wollen, ist es naheliegend, diese zu einem längeren Vektor zu konkatenieren. Oft sehen wir aber im Code stattdessen ein einfaches +. Wie kann das funktionieren???
Eine einfachere Frage: Unter welchen Umständen lässt sich für zwei Vektoren aus der Summe wieder das Paar rekonstruieren? Probieren Sie explizite Beispiele mit aus, etwa und . Überlegen Sie hinterher, wie das bei der eigentlichen Frage weiterhilft. (Stichwort: Wenn und aus komplementären Unterräumen kommen – oder das Netz lernen kann, sie dort hinzulegen –, verliert die Summe nichts.)
Übung
Ein RNN mit , , , und der Eingabefolge .
Berechnen Sie (zwei Nachkommastellen genügen).
Wiederholen Sie mit und mit . Wie lange „erinnert“ sich das Netz jeweils an die 1 vom Anfang? Tipp: Nach dem ersten Schritt ist die Eingabe 0, es bleibt also eine Multiplikation mit pro Schritt.
Antwortprobe: Bei (2) fällt einer der drei Verläufe deutlich langsamer ab als die anderen.