Representation Learning
Worum geht’s?
Gegeben Daten, die einer unbekannten Verteilung folgen, wollen wir automatisch Features entwickeln, die spätere Aufgaben mit diesen Daten erleichtern. Spätere Aufgaben können sein: die Verteilung schätzen (um daraus zu sampeln, z.B. Text generieren), Klassifikation (z.B. Spam/Ham), Ähnlichkeit bestimmen (z.B. zwischen zwei Texten).
Oberste Ziele sind eine höhere Modellperformance für die späteren Aufgaben und bessere Generalisierbarkeit. Ein weiteres Ziel ist möglicher Transfer: Features, die für eine Aufgabe gelernt wurden, für eine andere nutzen (Beispiel: Übersetzungen – ein Encoder für Englisch, der auch für Französisch etwas taugt).
Wie genau? Zwei Mechanismen haben wir bereits gesehen: Dimensionsreduktion durch „intelligentes Downsampling“ bzw. Kompression (wie beim Autoencoder), und nichtlineare neue Features aus alten Features entwickeln (jede versteckte Schicht tut das).
Andere Features, die man manuell hinzufügen kann
Representation Learning ist die automatische Variante von Feature Engineering. Zwei klassische, handgemachte Beispiele:
Das Spektrogramm einer Audiodatei. So wird eine Waveform-Datei (z.B. eine Unterhaltung, ein Song) in ein Bild umgewandelt, indem die (Kurzzeit-)Fourier-Transformation genutzt wird. Relevant für Sprachsynthese und Spracherkennung.
Enthält ein Bild horizontale Kanten? Vertikale Kanten? Ecken? Ein Klassifikator für „das Bild enthält ein Haus“ ist leichter zu trainieren, wenn nicht nur Pixelwerte eingehen, sondern auch die Positionen von Ecken und Kanten. Die automatische Variante davon sind CNNs (Convolutional Neural Networks), siehe das Kapitel „Faltung und CNNs“.
node2vec
word2vec aus anderer Perspektive
Ein Satz, wie er bei word2vec eingeht, kann als linearer Graph modelliert werden: „Die Katze frisst Mäuse“. Mehrere Sätze können gleiche Wörter enthalten, damit bilden mehrere Sätze größere Graphen mit linearen Teilgraphen: „Der Hund frisst Leckerli“ teilt sich den Knoten „frisst“ mit dem ersten Satz.
Mit diesem Graphen allein lassen sich die Sätze nicht zurückgewinnen, denn „Der Hund frisst Mäuse“ sowie „Die Katze frisst Leckerli“ sind keine ursprünglichen Sätze, aber Pfade im Graphen. Besser wäre ein probabilistisches Modell auf Grundlage des Graphen: für jeden Knoten eine Wahrscheinlichkeitsverteilung auf den Knoten mit Kante , abhängig von der vorherigen Kante (eine Markovkette zweiter Ordnung).
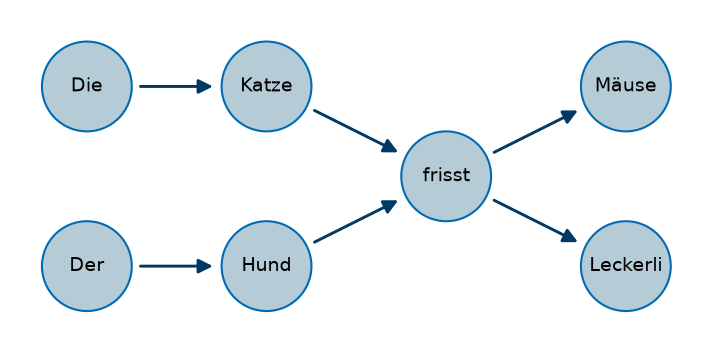
Zwei Sätze als Graph: Der gemeinsame Knoten „frisst“ erzeugt Pfade, die keine ursprünglichen Sätze sind.
Aus anderer Perspektive: von Graphen zu Sätzen
Umgekehrt: Gegeben ein Graph, lassen sich daraus „Sätze“ bilden durch wiederholtes Verfolgen einer ausgehenden Kante. Vereinfachtes probabilistisches Modell auf Grundlage des Graphen: für jeden Knoten eine Gleichverteilung auf den Knoten mit Kante , unabhängig von der vorherigen Kante. Das ist ein Random Walk.
Beispiel mit einem Graphen aus der Wikipedia: Von „Katze“ führen Links zu „Maus“, „Mäuse“, „Sendung mit der Maus“; von „Maus“ zu „Computermaus“, „Lesk-Algorithmus“ (Wortsinn-Disambiguierung), … Daraus lassen sich endliche Random Walks bilden. Ziel: Verstehe einen Knoten durch seinen Kontext. Beispiel: Haushund und Hausmaus haben gemeinsame eingehende Links.
node2vec praktisch
Bei node2vec (Grover & Leskovec, 2016) haben wir zwei Schritte:
Generiere „Sätze“ (Knoten, [Kontext]) durch Random Walks auf dem Graphen.
Benutze word2vec-Skip-gram-Training auf den Sätzen.
Schritt 1 ist sehr ressourcenintensiv, kann aber parallelisiert werden. Software dafür: StellarGraph (OK API, nutzt gensim), eine schnelle Implementierung mit Apache Spark (arXiv:1805.00280), und als Modul für PyTorch torch_geometric.nn.models.Node2Vec (siehe auch das Beispiel).
Beispielanwendungen: Recommendations using node2vec – aus einem Netflix-Datensatz werden Serien und Filme sowie deren Genres extrahiert und zu einem bipartiten Graphen Titel Genre gebaut; nach node2vec kann man zu einem Titel im Latent Space nach ähnlichen Titeln suchen. Ähnlich, mit mehr Klassen von Knoten: Knowledge graph analysis with node2vec.
Graph Neural Networks
Etwas anderes: Anstatt die Struktur des Graphen in (Knoten, Kontext)-Paare zu entwickeln, lässt sich die Struktur des Graphen auch direkt im neuronalen Netz nutzen. Beispiel: Ein Graph mit Knoten Kaffee, Tee, Kanne, Tasse, Mühle. Jeder Knoten trägt einen Feature-Vektor, und in jeder Schicht des Netzes aktualisiert jeder Knoten seinen Vektor aus den Vektoren seiner Nachbarn – Message Passing. Mit der Adjazenzmatrix des Graphen ist das eine Matrixmultiplikation: Stehen die Knotenvektoren als Zeilen in , so enthält für jeden Knoten die Summe der Vektoren seiner Nachbarn. Die Gewichte sind für alle Knoten gleich, sodass das Netz auf Graphen beliebiger Größe funktioniert. Das ist der Grundbaustein von Graph Neural Networks; wir vertiefen das hier nicht.
Vertiefung: die Message-Passing-Formel
Dabei ist die Nachbarschaft von ; verarbeitet den eigenen Vektor, die Nachrichten der Nachbarn. In Matrixform, mit den Knotenvektoren als Zeilen von : . Varianten unterscheiden sich darin, wie die Nachbarn gewichtet werden (Mittelwert statt Summe, Normierung mit dem Grad, gelernte Attention).
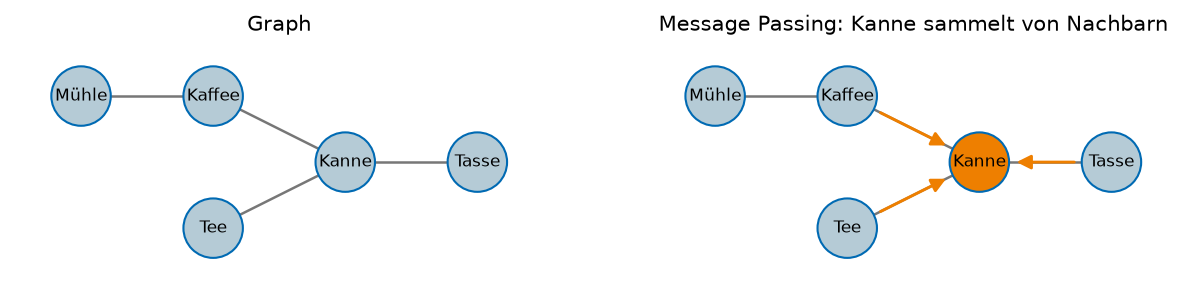
Message Passing in einem GNN: Jeder Knoten aktualisiert seinen Vektor aus den Vektoren seiner Nachbarn, hier für „Kanne“.