Lernen ohne Label
Im Kontrast zu unserem bisherigen Vorgehen
Bisher haben wir ein Neuron oder ein neuronales Netz zur Klassifikation oder Regression verwendet: Eine nicht bekannte Funktion , für die wir manche Werte kennen (Label für Trainingsdaten ), wollen wir mit dem Modell „schätzen“. Was, wenn wir keine Label haben?
Herleitung zur abstrakten Idee
Ohne Label müssen wir den Output des neuronalen Netzes anders bewerten. Wie Erfolg messen? Welches Ziel ist im Training noch sinnvoll?
Ein mögliches Ziel: Transformation der Eingabe in ein anderes Koordinatensystem (Feature Extraction). Das kann man rückgängig machen – und messen, wie gut das klappt. Abstrakt: ist nicht bekannt, aber ist bekannt, nämlich . Hier heißt Encoder und Decoder, und soll die Identität sein.
Das allein wäre trivial (). Interessant wird es mit einer Einschränkung: Dimensionsreduktion. Versuche, die Dimensionalität zu reduzieren ohne Informationsverlust – transformiere die Eingabe in ein kleineres Koordinatensystem, sodass man es trotzdem rückgängig machen kann. Der Encoder mit muss dann lernen, was an den Daten wesentlich ist.
Loss-Funktion
Trainingsziel: Output so ähnlich wie möglich zum Input (Rekonstruktion). Vergleiche Input mit Output, z.B. über die mittlere quadratische Abweichung der Pixelwerte:
Der Autoencoder ist also ein neuronales Netz mit einem „Flaschenhals“ in der Mitte, trainiert mit MSE zwischen Ein- und Ausgabe – und die Label sind die Eingaben selbst. Man nennt das auch self-supervised.
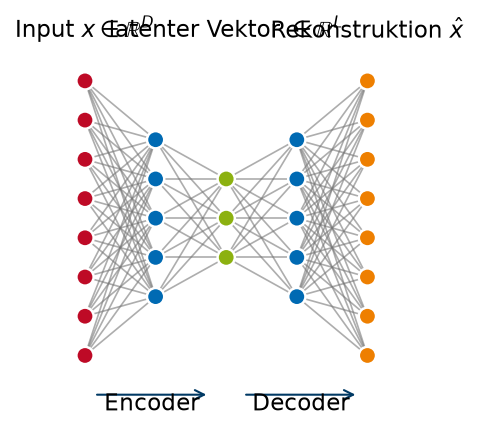
Autoencoder schematisch: Encoder, Flaschenhals (latenter Vektor), Decoder.
Im Vergleich zur Dimensionsreduktion mit PCA: Ist der Autoencoder linear (keine Aktivierungsfunktionen), so findet er denselben Unterraum wie PCA. Mit Nichtlinearitäten kann er gekrümmte Strukturen in den Daten erfassen, die PCA verfehlt, und rekonstruiert z.B. Bilder bei gleicher Dimension des Flaschenhalses deutlich besser.
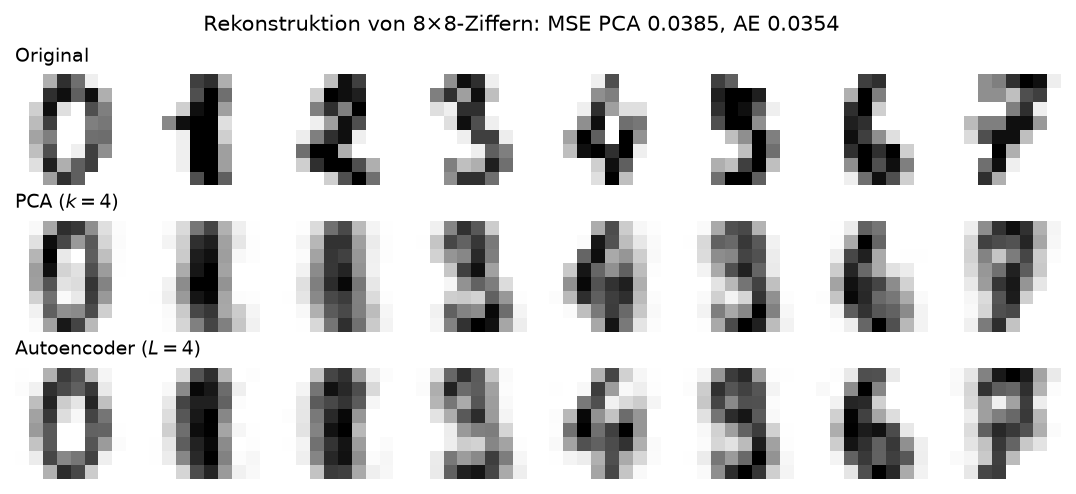
Rekonstruktion von 8×8-Ziffern aus scikit-learn durch PCA mit 4 Komponenten und durch einen kleinen Autoencoder mit (erzeugt mit sklearn.neural_network.MLPRegressor).
Autoencoder für MNIST
Das Autoencoder-Layout
Noch einmal genauer: Ein Autoencoder ist eine Regression mit Input , einem Vektor der Länge . Der Encoder reduziert in mehreren Schichten von Dimension auf Dimension , der Decoder erhöht in mehreren Schichten von Dimension zurück auf Dimension . Input und Output liegen im „Datenraum“ (bei Bildern: „Pixelraum“, pixel space); die Flaschenhals-Schicht der Dimension ist der latente Raum (latent space).
Anwendungsbeispiel: MNIST
MNIST besteht aus Graustufen-Bildern handgeschriebener Ziffern 0–9, mit Label; 60 000 Trainings- und 10 000 Testbilder. Mögliche Tasks:
Unsupervised: Kompression der Bilder. Autoencoder = Encoder + Decoder, der Encoder ist der Kompressor.
Unsupervised: neue Bilder generieren. Die Verteilung der Punkte im latenten Raum modellieren, sampeln, dekodieren – dazu mehr im nächsten Kapitel (VAE).
Supervised: Klassifikation.
Supervised: neue Bilder mit vorgegebener Ziffer generieren.
Zunächst: Kompression und Klassifikation, mit den Zielen Accuracy erhöhen und Overfitten vermeiden. Variationsmöglichkeiten dafür gibt es an drei Stellen: die Daten modifizieren (putzen?), die Modellarchitektur (tiefer?), und die Trainings-Hyperparameter (wie genau wird gelernt?).
Code-Beispiel: Modellarchitektur
Ein Autoencoder in PyTorch ist ein nn.Module mit zwei nn.Sequential-Blöcken. Schematisch:
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

device = torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
IMAGESIZE = 28

class Autoencoder(nn.Module):
    def __init__(self, latent_dim=12):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(IMAGESIZE**2, 256), nn.ReLU(True),
            nn.Linear(256, 64), nn.ReLU(True),
            nn.Linear(64, latent_dim),
        )
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, 64), nn.ReLU(True),
            nn.Linear(64, 256), nn.ReLU(True),
            nn.Linear(256, IMAGESIZE**2), nn.Sigmoid(),
        )

    def forward(self, x):
        latent = self.encoder(x)
        return latent, self.decoder(latent)
Das Sigmoid am Ende des Decoders sorgt dafür, dass die Ausgabe wie Pixelwerte in liegt. Man kann auch dem Encoder ein Sigmoid ans Ende setzen; nötig ist das erst für den Sparse Autoencoder weiter unten, dessen Strafterm latente Werte in voraussetzt. Die Architektur lässt sich mit Netron visualisieren, nachdem man das Modell mit torch.save(model, 'model.pth') gespeichert hat.
Code-Beispiel: Training
transform_mnist = transforms.Compose([
    transforms.ToTensor(),
    transforms.Lambda(lambda x: x.view(-1)),   # 28x28 -> 784
])
mnist_data = datasets.MNIST(root='./data', train=True, download=True,
                            transform=transform_mnist)
data_loader = DataLoader(dataset=mnist_data, batch_size=512,
                         num_workers=8, shuffle=True)

model = Autoencoder(latent_dim=12).to(device)
reconstruction_criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=1e-2)

for epoch in range(15):
    for img, labels in data_loader:
        img = img.to(device)
        latent, reconstructed = model(img)
        reconstruction_loss = reconstruction_criterion(reconstructed, img)
        loss = reconstruction_loss
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
Neu gegenüber dem Kapitel „Tensoren“ sind Dataset und DataLoader: Der Datensatz liefert einzelne Samples (hier mit einer transform, die das Bild in einen Vektor der Länge 784 verwandelt), der Loader fasst sie zu zufällig gemischten Mini-Batches zusammen. Die Trainingsschleife selbst ist dieselbe wie immer, nur dass das Label das Bild selbst ist.
Tricks beim Training
Mehr Epochen trainieren! – aber nicht beliebig viele: Wenn der Loss auf dem Testset wieder steigt, während er auf den Trainingsdaten weiter sinkt, overfittet das Modell. Early Stopping heißt, an diesem Punkt aufzuhören (bzw. die Gewichte von dort zu behalten).
Data Augmentation: die Trainingsdaten durch zufällige Transformationen vervielfachen, die das Label nicht ändern – Bilder leicht drehen, verschieben, spiegeln, verrauschen. Das Modell sieht nie zweimal dasselbe Bild und kann es nicht auswendig lernen; auch das ist Regularisierung.
Lernrate anpassen – statt
lr=1e-3mal mitlr=1e-2probieren.Die Gewichte können zu groß werden, dann kann man eine L2-Regularisierung nutzen, den Weight Decay (als Parameter für den Optimierer, wie die Lernrate):
weight_decay=1e-5. Das addiert zum Loss und zieht die Gewichte bei jedem Schritt ein wenig Richtung null.SGD kann sehr langsam sein. Es gibt eine ganze Reihe von Tricks wie z.B. eine adaptive Lernrate und cleveres Mitteln über mehrere Batches hinweg, die in Adam implementiert sind:
optim.Adam(model.parameters(), lr=1e-3). Faustregel für den Rest des Kurses: Adam statt SGD, ohne dass wir Optimierer weiter vertiefen. Was Adam genau tut, steht im Kapitel „Optimierer“.Oft ist I/O oder die CPU ein Bottleneck beim Laden der Daten. Im Konstruktor des
DataLoadermit anderenbatch_sizes experimentieren (im Zweifel mehr, bis Out of Memory), und mehrere CPU-Kerne zum Laden der Daten nutzen:num_workers=8.
Label Autoencoder
Supervised: Klassifikator
Ein „klassischer“ Klassifikator-Ansatz auf Basis des Autoencoders: Encoder vom Autoencoder, dann ein linearer Layer auf 10 Dimensionen. Dessen Ausgabe sind die Logits; erst ein Softmax darauf macht daraus Wahrscheinlichkeiten, und ein dahinter die „harte“ Klassifikation.
Loss-Funktion: Negative Log-Likelihood = Kreuzentropie Kullback-Leibler-Divergenz zwischen echten Labels und Vorhersage (siehe Kapitel „Loss-Funktionen und Maximum Likelihood“). Das ist der classification loss, im Gegensatz zum reconstruction loss. In PyTorch: nn.CrossEntropyLoss(), das Softmax und NLL in einem Schritt (numerisch stabiler) berechnet und direkt auf die Logits angewendet wird. Deshalb gehört das Softmax nicht ins Modell, wenn man diese Loss-Funktion benutzt – sonst wird zweimal normiert, die Verteilung wird flach und das Training langsam. Erst bei der Inferenz, wenn man Wahrscheinlichkeiten sehen will, wendet man torch.softmax von Hand an.
Label Autoencoder
Warum nicht beides? Encoder vom Autoencoder, darauf der lineare Layer auf 10 Dimensionen (Logits) – und daneben der Decoder vom Autoencoder. Input ist ein Bild, Output sind Rekonstruktion und Label-Vorhersage, und die Loss-Funktion ist
Der Encoder muss jetzt einen latenten Raum finden, der beides kann: das Bild rekonstruieren und die Ziffer erkennen. Die Rekonstruktion wirkt dabei wie eine Regularisierung des Klassifikators – der latente Raum darf nichts Wichtiges wegwerfen.
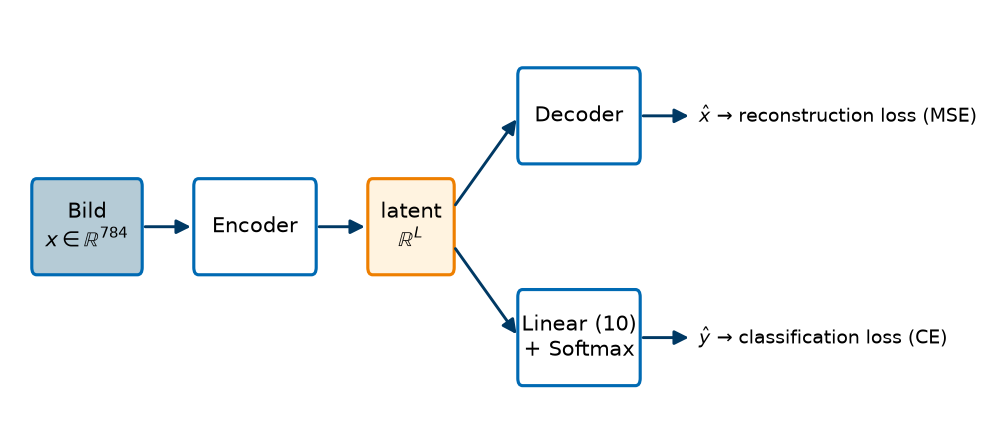
Label Autoencoder: ein Encoder, zwei Köpfe, zwei Loss-Terme.
Tricks bei der Modellarchitektur
Mehr Layer!
Dem Problem sterbender Neuronen entgegenwirken mit anderen Aktivierungsfunktionen als ReLU, z.B. dem Swish (in PyTorch
nn.SiLU).Dropout-Layer: Zufällig ein paar Einträge des eingehenden Vektors auf 0 setzen (
nn.Dropout(0.3)setzt 30 % auf null, nur während des Trainings). Verhindert zu starke Konzentration auf einige wenige Neuronen und wirkt gegen Overfitting.Batch-Normalization-Layer (
nn.BatchNorm1d): Nach jedem Batch den Output des vorigen Layers auf eine Normalverteilung normieren, d.h. Mittelwert abziehen und durch die Standardabweichung teilen, beides über den Batch berechnet. Die Transformation (Skalierung und Translation) auf eine andere Normalverteilung als die Standardnormalverteilung sind erlernbare Gewichte dieses Layers. Theoretisch etwas kompliziert (wieso es nützt), praktisch sehr nützlich.
Autoencoder-Varianten
Zur Erinnerung: Ein Autoencoder besteht aus Encoder und Decoder , mit dem latenten Raum der Dimension als Flaschenhals. In diesem Abschnitt variieren wir die Loss-Funktion und die Eingabe, und sehen, was das mit dem latenten Raum macht.
Sparse Autoencoder
Idee: die Loss-Funktion um Strafterme ergänzen. Hier: dafür sorgen, dass ein latenter Vektor dünn besetzt (sparse) ist, also die meisten Einträge nahe 0 sind.
Lösung: Unter der Annahme, dass die latenten Vektoren Einträge in haben (z.B. durch ein Sigmoid am Ende des Encoders), betrachten wir für jede latente Dimension die mittlere Aktivierung über den Batch und bestrafen die Kullback-Leibler-Divergenz zwischen der Bernoulli-Verteilung mit Wahrscheinlichkeit und der Bernoulli-Verteilung mit Wahrscheinlichkeit :
Der Term ist 0 genau dann, wenn jede latente Dimension im Mittel nur zu 10 % „an“ ist. Im Code muss er ausdrücklich zum Rekonstruktions-Loss addiert werden, loss = reconstruction_loss + beta * sparsity_loss; eine Funktion, die ihn nur berechnet, ändert am Training nichts. Dense latents nutzen alle Dimensionen für jeden Datenpunkt; sparse latents verteilen die Datenpunkte auf wenige aktive Dimensionen, was die einzelnen Dimensionen interpretierbarer macht.
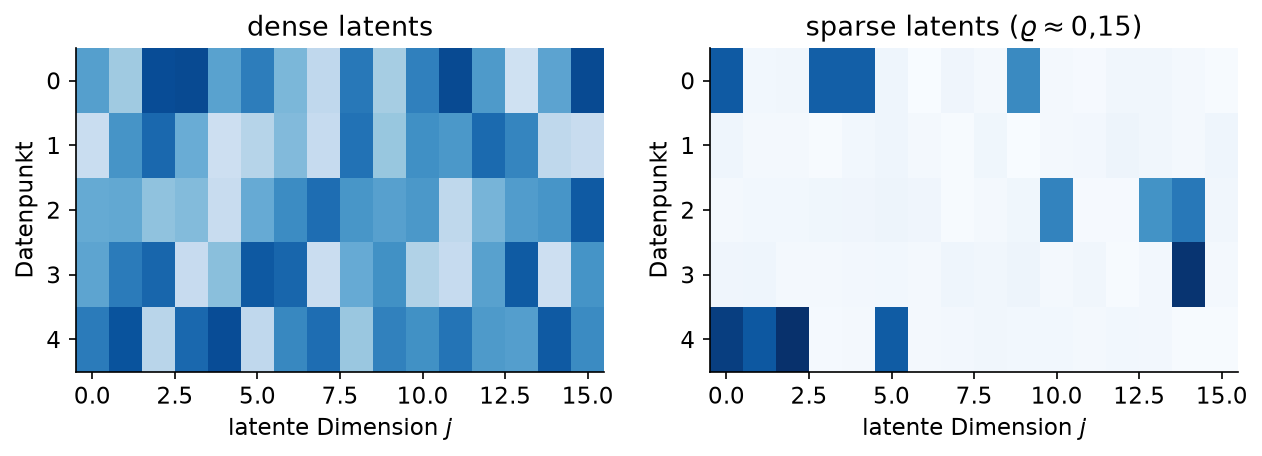
Latente Vektoren von fünf Datenpunkten (Zeilen), 16 Dimensionen (Spalten): dicht besetzt vs. dünn besetzt.
Denoising Autoencoder
Idee: Daten nicht putzen, sondern verschmutzen. Noise generieren, auf die Daten addieren, , und das als Input für den Autoencoder verwenden. Die Loss-Funktion vergleicht aber mit dem sauberen :
Das zwingt das Netzwerk dazu, einzelne Pixel nicht zu stark zu gewichten und eher globale Strukturen zu suchen – ein einzelner verrauschter Pixel darf die Rekonstruktion nicht kippen.
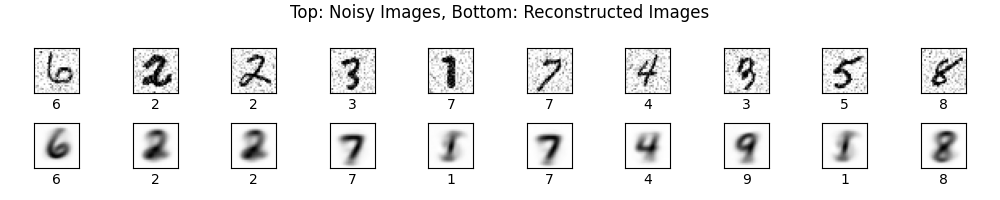
Denoising Sparse Label Autoencoder auf MNIST (Musterlösung zu einem Übungsblatt, WiSe 2025/26): verrauschte Eingabe, Rekonstruktion, Original.
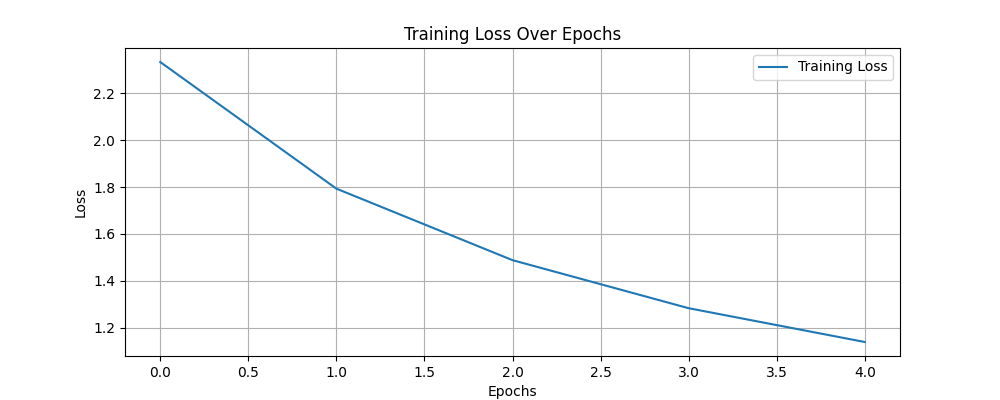
Dasselbe Modell: Loss-Kurve über die Epochen.
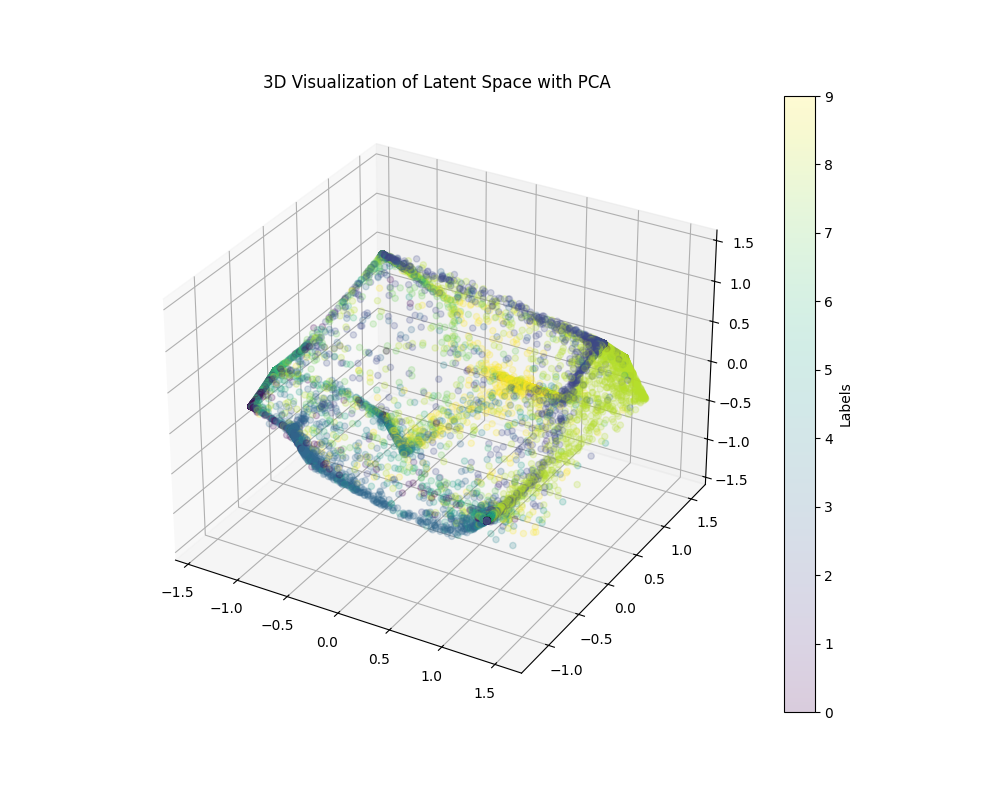
Der latente Raum desselben Modells, per PCA auf zwei Dimensionen projiziert und nach Ziffer eingefärbt.
Die drei Abbildungen oben stammen aus einem Denoising Sparse Label Autoencoder – alle Tricks auf einmal, mit SiLU, BatchNorm und Dropout: verrauschte Eingabe hinein, sauberes Bild und Ziffer heraus, dazu ein Sparsity-Strafterm auf dem latenten Vektor.
Bisher, und was es bringt
Wir haben das Autoencoder-Design eingesetzt, um Bilder zu komprimieren (mit Sparsity Constraint), Bilder zu klassifizieren, Bilder zu entrauschen – und all das zusammen. Ein ML-System, welches diese Bilder verarbeiten soll, kann nun den fertig trainierten Encoder verwenden und direkt auf den Repräsentationen im Latent Space arbeiten. Das ist Modularisierung im Training: Der Encoder wird einmal trainiert und dann als Feature-Extraktor wiederverwendet.
Frage: Welche Struktur finden wir im Latent Space bzw. in den Latent Vectors der Daten? Die Latent-Manifold-Hypothese besagt, dass die Daten in nahe einer niedrigdimensionalen gekrümmten Fläche (Mannigfaltigkeit) liegen und der latente Raum diese Fläche „flach“ parametrisiert. Dazu mehr im Kapitel „Latente Räume geometrisch“.
Später werden wir das Autoencoder-Design einsetzen, um Text (Strings) natürlicher Sprache zu kodieren, sodass die latente Repräsentation interessante Struktur aufweist – das ist word2vec (Kapitel „word2vec“).
Übung
Ein Autoencoder für MNIST: , alle Layer voll verbunden mit Bias.
Wie viele Parameter hat er? Wie viele davon im Encoder? Tipp: Ein Layer hat Parameter.
Beim Denoising-Autoencoder: Auf welche der beiden Größen – Eingabe oder Zielbild – kommt das Rauschen, und was wäre der Effekt, wenn man es auf die andere legte?
Antwortprobe: Bei (1) liegt das Ergebnis zwischen 200 000 und 250 000.