Das Geheimnis um Deep Learning lüften
Warum – und wie genau – funktioniert Deep Learning so gut? Die Zutaten, die wir bisher haben:
Das einzelne Neuron = Skalarprodukt + Aktivierungsfunktion.
Gradientenabstieg: Lernen in Richtung der Ableitung einer Loss-Funktion.
Backpropagation: clever die Ableitung berechnen für tiefe Netze.
Was noch fehlt, und was wir in diesem und den nächsten Kapiteln angehen:
Sinnvolle Loss-Funktionen festlegen: Regression mit MSE, (binäre) Klassifikation mit (B)CE; BCE vs. NLL vs. .
Architekturen neben einfachen MLPs, wie z.B. Autoencoder – und damit auch Representation Learning und Transfer Learning (Kapitel „Autoencoder“ und folgende).
Regularisierung und Tricks gegen verschwindende Gradienten (Kapitel „Aktivierungsfunktionen“, Dropout und Batch-Normalisierung im Autoencoder-Kapitel).
Hyperparameter wählen und optimieren; alles hängt von den Daten ab …
Und ganz grundsätzlich: Elementare Funktionen sind leicht approximierbar – das jetzt, zuerst von Hand (dieses Kapitel), dann als Satz (Kapitel „Universelle Approximation“).
Parameter von Hand wählen
Bevor wir Netze trainieren, überzeugen wir uns davon, dass die gesuchten Gewichte überhaupt existieren: Wir bauen kleine Netze von Hand.
Easy mode: Boolesche Variablen
Seien und , , also , , , . Welches neuronale Netz berechnet als Inferenz die Funktion ?
Idee: Schreibe als Verkettung von gewichteten Summen (= Skalarprodukten) und Aktivierungsfunktionen (z.B. oder ). Dabei müssen wir OR interpolieren – entscheiden, was z.B. sein soll – und extrapolieren – entscheiden, was z.B. sein soll. Denn ein neuronales Netz ist auf ganz definiert, nicht nur auf den vier Ecken.
Easiest mode: eindimensional
Sei mit der Interpretation , , und , . Also , , allgemeiner falls . Die Funktion
erfüllt die Eigenschaft, NOT zu inter- und extrapolieren. Als neuronales Netz: 1 Neuron, Gewicht , Bias , Aktivierungsfunktion .
Zurück zu OR
Ansatz: . Leider ist . Besser: – ein Neuron mit Gewichtsvektor , Bias und Aktivierungsfunktion mit Werten in . Dafür ändern wir die Interpretation leicht zu , . Damit ist der erste Ansatz wieder brauchbar: Dass herauskommt, stört nun nicht mehr, weil alles über null TRUE heißt. Softere Varianten sind also oder ; und noch besser, weil es Negatives sauber abschneidet:
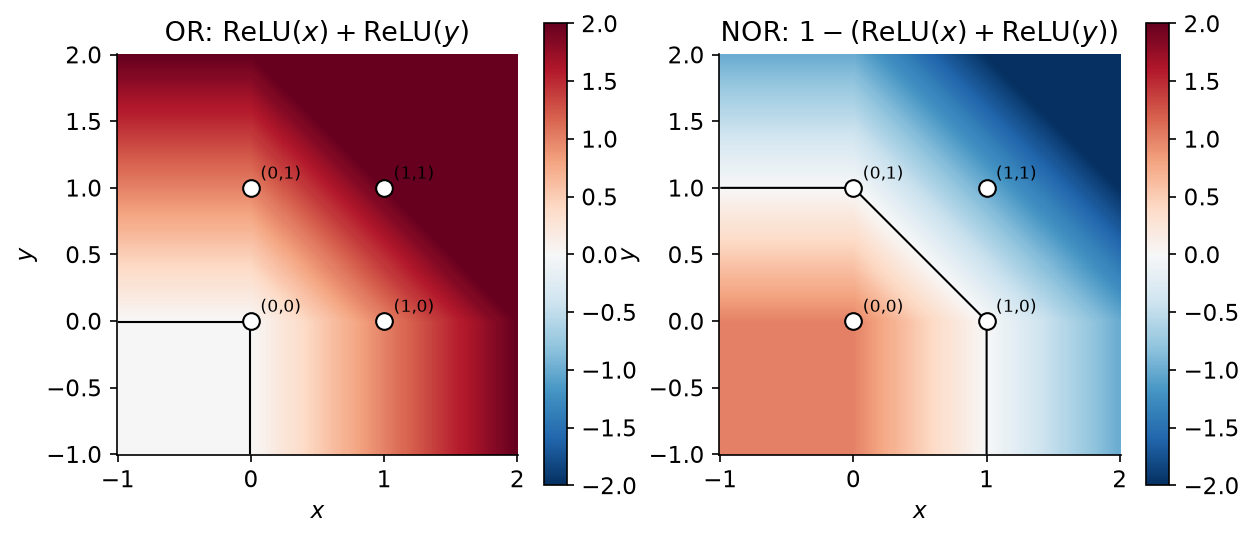
OR und NOR als Funktionen auf ganz : Die vier Booleschen Ecken sind markiert, die schwarze Linie ist die Nullstellenmenge.
Komplizierteres aus Einfachem: NOR
Sei , also und sonst . NOR = NOT OR, also für ein , welches OR implementiert. Mit und :
Als Netz: erste Schicht mit zwei ReLU-Neuronen, eines pro Eingabe (Gewicht 1, Bias 0), zweite Schicht mit Gewichtsvektor , Bias 1 und . Ein einzelnes Neuron mit Gewichtsvektor täte es nicht: Das berechnet , und das ist etwas anderes als – bei etwa 0 gegen 1. Auf den vier Booleschen Ecken fällt der Unterschied nicht auf, außerhalb schon, und genau darum geht es in diesem Kapitel.
Weiter so? XOR
Sei . Die „Region“ XOR in der Ebene, also die Punkte mit , ist der Schnitt von mit :
Setzt man das mit den obigen Bausteinen zusammen, so müsste es mit 4 Hidden Layers zu je 4 Neuronen klappen. Gradientenabstieg mit Backpropagation findet allerdings auch Approximationen mit 3 Hidden Layers – und mit 2 Hidden Layers (siehe die beiden Abbildungen unten aus dem TensorFlow Playground).
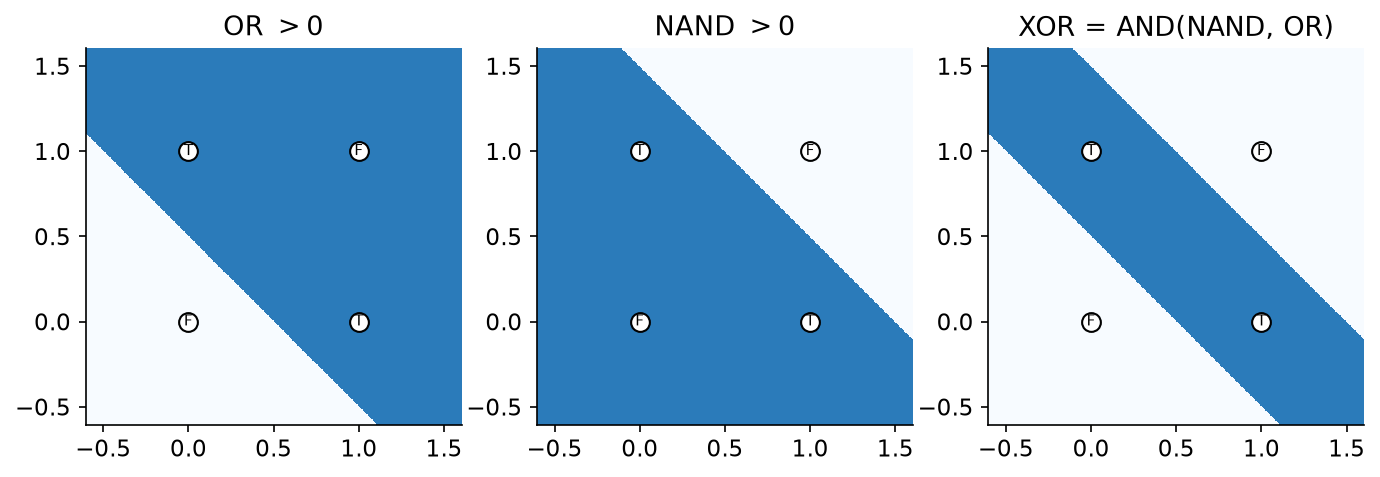
XOR als Schnitt von NAND und OR.
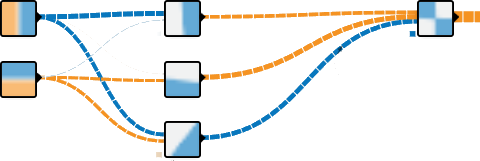
Vom Gradientenabstieg gefundene Approximation im TensorFlow Playground mit 3 versteckten Schichten.
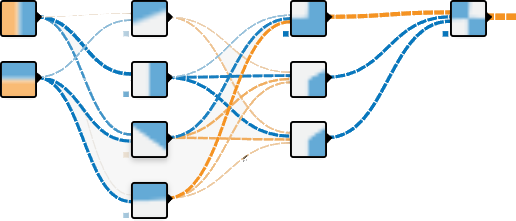
Dasselbe mit 2 versteckten Schichten.
Take-Home Message
Boolesche Funktionen lassen sich mit neuronalen Netzen darstellen bzw. approximieren, d.h. es gibt Gewichte, sodass die resultierende Funktion tut, was sie soll. Also kann auch Optimierung diese idealen Gewichte finden. Aus elementaren Funktionen lassen sich komplexe verknüpfen; neuronale Netze können aber auch „Abkürzungen“ nehmen und Platz verschwenden (überflüssige Neuronen).
Arithmetik
Wie können wir z.B. mit einem neuronalen Netz berechnen oder approximieren? Einfachere Probleme, die wir dafür zuerst lösen müssen: und .
Auf approximieren wir mit einer stückweise linearen Funktion an ganzzahligen Stützstellen. Die Interpolation durch die Punkte für hat auf die Steigung , also an jeder inneren Stützstelle einen Knick, bei dem die Steigung um 2 wächst – und jeder Knick ist eine ReLU:
Probe: und . Das ist ein Netz mit einer versteckten Schicht aus 6 ReLU-Neuronen (Gewicht 1, Bias für ) und einer linearen Ausgabeschicht mit Gewichten und Bias 9. Die Symmetrie haben wir dabei ignoriert – geht das besser? Der Betrag ist selbst ein kleines Netz, (zwei Neuronen mit Gewichten 1 und -1, dann ein Neuron mit Gewichtsvektor ), und damit reicht die Interpolation auf :
Das sind nur noch 3 Neuronen in der Interpolationsschicht – dafür ist das Netz tiefer, weil zwei Schichten vorweg kostet. Weniger Neuronen pro Schicht gegen mehr Schichten: ein Tausch, den wir noch öfter sehen werden.
In der Praxis könnte man PyTorch auch direkt bitten, oder exakt zu berechnen (Stichwort Gates, etwa in LSTMs), auch wenn man damit das reine MLP verlässt. Der Haken: Im Allgemeinen weiß man vorher nicht, ob man braucht, um die gesuchte Funktion gut zu approximieren.
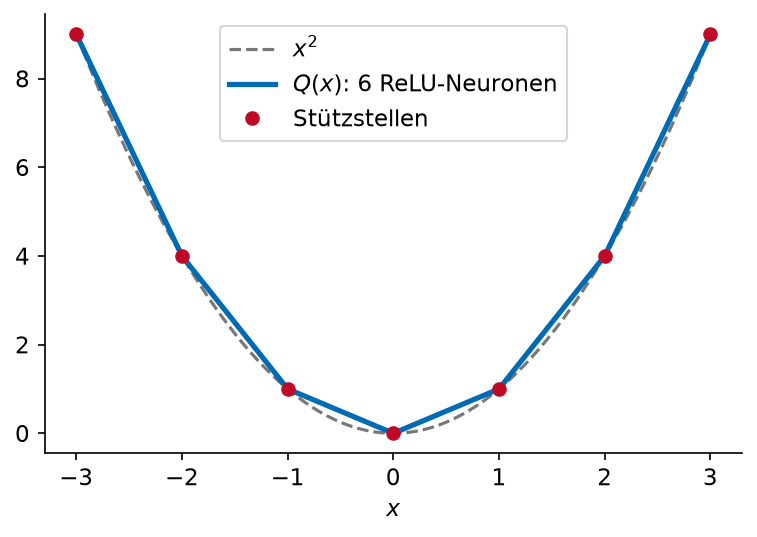
auf und die stückweise lineare Interpolation an ganzzahligen Stützstellen, ein Netz mit 6 ReLU-Neuronen.
Wenn gut approximiert werden kann, dann auch über die Polarisationsidentität:
Damit setzen wir für eine Approximation der Quadratfunktion
und sowie sind lineare Schichten. Mit MUL und Addition bekommen wir alle Polynome, und damit (Weierstraß) alle stetigen Funktionen auf beschränkten Bereichen.
Take-Home Message
Funktionen lassen sich mit neuronalen Netzen darstellen bzw. approximieren. Mit einer Lookup-Table (LUT) und Interpolation sind beliebig gute Näherungen auf beschränkten Definitionsbereichen möglich – so rechnet auch die GPU z.B. den Sinus aus. Außerhalb der Stützstellen wird die Approximation beliebig schlecht: Neuronale Netze interpolieren gut, extrapolieren schlecht.
Übung
Geben Sie Gewichte und Bias für ein einzelnes Perzeptron an, das AND auf berechnet. Prüfen Sie alle vier Eingaben nach.
Bauen Sie NAND aus Ihrem AND, ohne neu zu rechnen. Tipp: Was macht das Vorzeichenwechseln von und mit der Entscheidungsgrenze?
Antwortprobe: Bei (1) gibt es viele richtige Antworten; alle erfüllen dieselben vier Ungleichungen.