Universelle Approximation
Warum neuronale Netze funktionieren
Universelles Approximationstheorem, grobe Aussage (wir erinnern uns an das Kapitel „Netze von Hand bauen“): Mit neuronalen Netzen (beliebig viele Neuronen, beliebig viele Layer, fully connected, ReLU) lässt sich jede Funktion beliebig gut approximieren. Der Beweis in fünf Schritten:
Jede beschränkte messbare Funktion ist beliebig gut () durch einfache Funktionen approximierbar: und . Dabei sind einfache Funktionen endliche Linearkombinationen von Indikatorfunktionen messbarer Mengen. (Stetige Funktionen sind integrierbar, integrierbare Funktionen sind messbar.)
Eine Funktion (für messbar) ist messbar genau dann, wenn es eine Folge einfacher Funktionen gibt, die punktweise gegen konvergieren und erfüllen. Eine messbare Funktion ist integrierbar, wenn es eine dominierende integrierbare Funktion gibt, . Wir können also sagen: .
Jede einfache Funktion ist beliebig genau approximierbar durch Stufenfunktionen, d.h. endliche Linearkombinationen von Indikatorfunktionen von Intervallen. Also: .
Eine einzelne Stufe lässt sich mit einem einfachen neuronalen Netz realisieren: Zwei Neuronen mit sehr steilen Sigmoiden an den Intervallgrenzen, mit Gewichten und in der Ausgabeschicht, ergeben eine Stufe der Höhe auf dem Intervall (Grafik von Michael Nielsen, Kapitel 4 seines Buchs). Mit ReLUs statt Sigmoiden reichen zwei Neuronen dafür nicht: ist rechts von beiden Knicken affin mit Steigung und kommt nie auf null zurück – man bekommt eine Rampe mit Plateau, keinen Buckel. Für ein Dreieck über dem Intervall braucht man drei ReLUs, für ein Trapez mit flachem Dach vier.
Die leicht zu verstehende Konstruktion mit 2 Hidden Layers bei Michael Nielsen funktioniert auch mit beliebig hoher Ein- und Ausgabedimension, also zur Approximation von Funktionen . Es gibt auch Konstruktionen mit nur 1 Hidden Layer.
Die richtige Frage ist also nie „Geht das mit neuronalen Netzen?“ (Antwort: JA), sondern „Wie geht das am effizientesten mit neuronalen Netzen?“
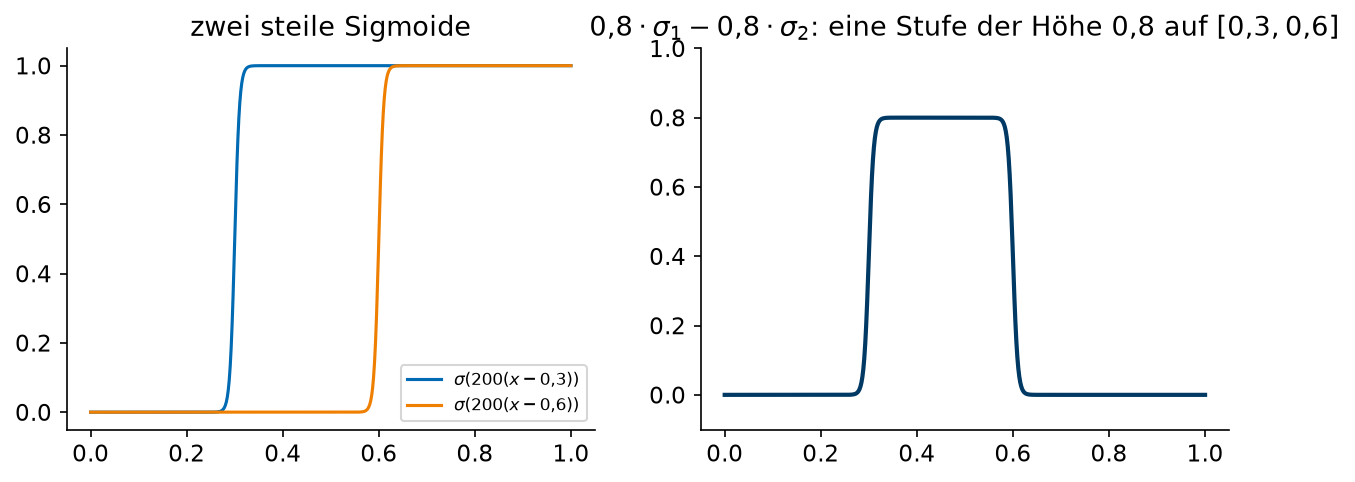
Zwei steile Sigmoide mit entgegengesetzten Ausgabegewichten ergeben eine Stufe. Aus Stufen baut man Stufenfunktionen, aus Stufenfunktionen approximiert man alles Messbare.
Präzisere Ergebnisse
Also: schmale, aber tiefe Netze reichen. Und noch präziser, mit Aussage über die Größe:
Siehe auch Andreas Thom, Approximation of functions by neural networks (arXiv:1901.10267, 2019). Die Anzahl der Gewichte wächst mit der Eingabedimension exponentiell (der Fluch der Dimensionalität), aber glattere Funktionen (größeres ) brauchen weniger – und die Tiefe wächst nur logarithmisch in der Genauigkeit.
Neuronale Netze vs. Bäume und Wälder
Umgekehrt lässt sich jedes ReLU-Netz auch als Entscheidungsbaum schreiben: Jedes ReLU-Neuron ist eine Ja/Nein-Entscheidung „?“, und die Regionen, in denen alle Entscheidungen feststehen, sind genau die Stücke, auf denen das Netz linear ist (Caglar Aytekin, Neural Networks are Decision Trees, arXiv:2210.05189, 2022). Der Baum ist allerdings exponentiell groß.
Übung
Geben Sie zwei Neuronen mit steilen Sigmoiden und Ausgabegewichte an, deren Summe die Funktion für und 0 sonst näherungsweise darstellt. Tipp: Zwei steile Stufen an den Stellen 1 und 2, die zweite mit umgekehrtem Vorzeichen. Der Steilheitsparameter bestimmt, wie gut die Näherung ist.
Mit ReLUs statt Sigmoiden reichen zwei Neuronen nicht. Wie viele brauchen Sie für ein Dreieck über , wie viele für ein Trapez mit flachem Dach? Tipp: Sehen Sie sich an, welche Steigung die Summe rechts von allen Knicken hat, und was sie sein müsste, damit die Funktion wieder auf 0 zurückkommt.
Wie viele Neuronen brauchen Sie für eine Treppenfunktion mit Stufen?
Antwortprobe: Die beiden Zahlen in (2) unterscheiden sich um genau eins, und die Antwort auf (3) ist linear in .