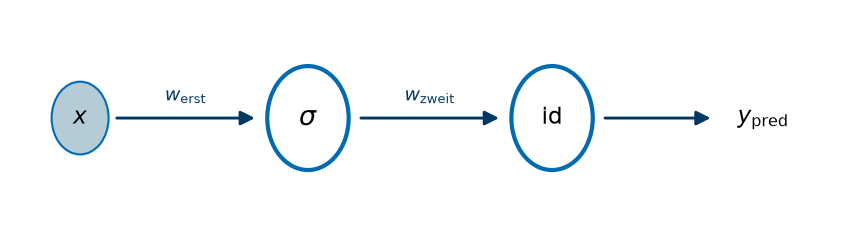
Eingabedaten sind eindimensional, ein einzelnes Neuron mit Aktivierungsfunktion σ produziert eine Ausgabe, die stecken wir in ein zweites Neuron mit Aktivierungsfunktion id. Also:
Wir planen eine Regression mit x,y∈R, daher nehmen wir den quadratischen Fehler – hier als reine Summe, ohne den Faktor N1 des MSE aus dem Kapitel „Gradientenabstieg“. Der Faktor verschiebt das Minimum nicht, nur die Größe des Gradienten und damit die passende Lernrate:
Nehmen wir W=(werst,wzweit), so können wir ypred als Funktion von W auffassen, ypred(W)=⟨wzweit,σ(⟨werst,x⟩)⟩, und die Ableitung nach W wie zuvor in Komponenten berechnen. Dafür brauchen wir zwei Bausteine:
Was ist die Ableitung von σ(f(w)) nach w? Kettenregel: dwdσ(f(w))=σ′(f(w))f′(w).
Was ist die Ableitung von ⟨w,x⟩ nach w, und von ⟨v,f(w)⟩ nach w? Es ist dwd⟨w,x⟩=x und dwd⟨v,f(w)⟩=⟨v,f′(w)⟩.
Das funktioniert, aber es ist unübersichtlich – und man sieht schon, dass Teilausdrücke mehrfach vorkommen: der Residuenterm yi−ypred,i und die Aktivierung σ(⟨werst,xi⟩) der ersten Schicht tauchen in beiden Regeln auf.
Beispielsetups 2 und 3: mehr Dimensionen, mehr Neuronen
Setup 2: Eingabedaten sind zweidimensional, sonst wie oben. Jetzt neu: werst∈R2. An den Formeln ändert sich nichts, die Skalarprodukte sind nur länger.
Setup 3: Eingabedaten sind zweidimensional, zwei Neuronen mit Aktivierungsfunktion σ und Gewichten u,v∈R2 produzieren Ausgaben, die stecken wir in ein drittes Neuron mit Aktivierungsfunktion id und Gewichten w∈R2:
Mehrere Neuronen, die parallel verarbeitet werden, bilden eine Schicht (Layer). Mehrmals lineare Regression ist multiple lineare Regression ist ein Linear Layer ist eine Matrix, deren Zeilen die Gewichtsvektoren sind. Schreiben wir also u,v als Zeilen in eine Matrix A∈R2×2 und benutzen σ auf Vektoren komponentenweise, so ist
(Wobei bei wTσ′(Ax)x die Dimensionen passend zu lesen sind: σ′(Ax) ist eine Diagonalmatrix, und das Ergebnis ist eine 2×2-Matrix, deren Eintrag (j,k) gleich wjσ′((Ax)j)xk ist.)
Idee: Berechne für ypred gleichzeitig die Daten für den Gradienten. Nach der Kettenregel dxdf(g(x))=f′(g(x))g′(x) mit g(x)=σ(Ax) und f(z)=wTz berechnen wir zuerst g und g′ vom ersten Layer, dann damit den nächsten Layer, usw. bis zum letzten. Die Zwischenergebnisse der Vorwärtsrechnung sind genau das, was die Rückwärtsrechnung braucht.
Wir verwenden die Notation der Differentiale: dE ist die lineare Änderung von E bei einer infinitesimalen Änderung der Parameter, und ∇bE bezeichnet den Gradienten von E nach b (mit der Konvention dE=⟨∇bE,db⟩). Wir arbeiten uns von hinten nach vorn (backwards differentiation).
denn y ist konstant. Weiter ist dypred=d(b3+W3z3)=db3+dW3z3+W3dz3. Für die Ableitung nach b3 betrachten wir nur den ersten Term: dE=rTdb3, also
Woher kommt das? Aus dE=rTdW3z3 soll ein Ausdruck der Form ⟨∇W3E,dW3⟩=tr((∇W3E)TdW3) werden. Der Skalar rTdW3z3 ist seine eigene Spur, und die Spur darf zyklisch vertauscht werden: tr(rTdW3z3)=tr(z3rTdW3). Der Vergleich mit tr((∇W3E)TdW3) liefert (∇W3E)T=z3rT. Wer das nicht mag, rechnet komponentenweise: ∂E/∂(W3)jk=rj(z3)k, dasselbe Ergebnis.
Das ist ein äußeres Produkt: Der Gradient nach der Gewichtsmatrix ist Residuum mal Eingabe der Schicht, transponiert – so wie beim einzelnen Neuron der Gradient nach w gleich Fehler mal x war.
Nächste Schicht. Jetzt können wir b3 und W3 als Konstanten sehen: dE=rTW3dz3+irrelevante Terme. Mit der Kettenregel gilt dzdtanh(f(z))=(1−tanh(f(z))2)f′(z), also
Das Fehlersignal wird von Schicht zu Schicht rückwärts propagiert: mit der transponierten Gewichtsmatrix multipliziert und mit der Ableitung der Aktivierungsfunktion gewichtet. Man nutzt die Zwischenschritte zk aus der Vorwärtsrechnung, um den vollen Gradienten effizient zu berechnen – ein Vorwärtsdurchlauf, ein Rückwärtsdurchlauf, fertig. Der Aufwand ist etwa das Doppelte einer Inferenz, unabhängig von der Anzahl der Parameter. Das ist Backpropagation, und danach kommt Gradientenabstieg.
Genau das tut loss.backward() in PyTorch (Kapitel „Autograd und Berechnungsgraph“): Beim Vorwärtsrechnen merkt sich jeder Tensor mit requires_grad, aus welcher Operation er entstanden ist (der Berechnungsgraph), und backward läuft diesen Graphen rückwärts ab und schreibt die Gradienten in die .grad-Attribute der Parameter. optimizer.step() macht dann W←W−ρ∇WE.
Noch einmal systematisch, als Wiederholung und Zusammenfassung aus der Übung – denn Backpropagation ist Klausurstoff, und die Formulierung als Induktion ist die, mit der man jede Architektur erschlägt.
Im Forward Pass speichern wir für jede Rechenoperation das Zwischenergebnis und merken uns die Ableitung der einzelnen Rechenoperation und auf welche vorangehenden Ergebnisse wir zurückgreifen müssen (Konstruktion des DAG).
Im Backward Pass können wir für jede Rechenoperation jeweils nach den Gewichten ableiten, die für diese Operation relevant sind. Wenn wir nach Gewichten ableiten, von denen die vorangegangenen Rechenoperationen abhängen, müssen wir die Kettenregel anwenden. Dazu benötigen wir nur die Ableitung der neuen Rechenoperation (gespeichert im Forward Pass), den Wert der Rechenoperation (gespeichert im Forward Pass) und die Ableitung der vorangegangenen Rechenoperationen.
Mit vollständiger Induktion sehen wir also: Wir können alle Ableitungen berechnen mit einem Durchlauf durch den DAG. Insbesondere können wir die Loss-Funktion (das „Ende“ des DAG) nach allen Gewichten ableiten und so den vollständigen Gradienten berechnen.
Wir bezeichnen den Input als x∈X. Die „bisherigen Rechenoperationen“ sind eine Abbildung Y:X→Y, also y:=Y(x;wY), deren Ableitungen dwYdY(x;wY) wir per Induktion kennen. Die „nächste Rechenoperation“ ist eine Abbildung Z:Y→Z, deren Ableitungen dydZ und dwZdZ wir kennen. Die Kettenregel erlaubt uns, Z(Y(x;wY);wZ) nach wY abzuleiten:
Spezialfälle: Wenn die nächste Rechenoperation der Loss ist, gibt es keine „neuen Gewichte“, dann ist nur die Ableitung nach „bisherigen Gewichten“ relevant. Der Induktionsanfang ist gegeben, indem Y die Identitätsfunktion ist (Ableitung ist 1). In knapperer Notation, mit Kleinbuchstaben als Funktionsnamen:
Nicht konkret genug? Ein weiteres einfaches Beispiel
Wir wählen als Input x∈X⊆Rn. Im Beispiel soll y:=y(x;w):=w⋅x sein, also ein linearer Layer. Die „nächste Rechenoperation“ ist z:R→R, und zwar z:=z(y):=ReLU(y)=max(0,y). Die Ableitung nach y ist [y>0]. Aus dwdz=dydz⋅dwdy wird also
Ein Netz x→y=ReLU(vx)→z=ReLU(wy) mit v=2, w=−1,
Eingabe x=3 und Ziel t=1; Loss L=21(z−t)2.
Forward Pass: Berechnen Sie y, z und L.
Berechnen Sie ∂w∂L und ∂v∂L.
Tipp: ∂z∂L=z−t, die schwache Ableitung von ReLU an der
Stelle a ist [a>0], und der Gradient eines Gewichts ist Eingabe des Neurons mal
Ableitung des Fehlers nach seiner Ausgabe.
Setzen Sie w=+1 und rechnen Sie noch einmal. Was hat sich an
∂v∂L qualitativ geändert, und warum?
Antwortprobe: In genau einem der beiden Fälle ist ∂v∂L=0.
Und eine größere, wenn Sie Lust haben: Nehmen Sie das Beispiel aus dem Abschnitt „Nicht konkret genug?“ (y=⟨a,x⟩, dann z=ReLU(y)) und geben Sie der ersten Schicht ein zweites Neuron, also eine zweite Zeile a′∈Rn. Der Loss ist dann ∥z−zground truth∥2 mit z∈R2. Leiten Sie nach beiden Zeilen ab und prüfen Sie, dass die beiden Gradienten sich nicht gegenseitig beeinflussen.