Im ersten Abschnitt basteln wir eine S-förmige Kurve aus dem , haben aber keine Interpretation dafür. Danach bauen wir die S-Kurve von der Wahrscheinlichkeitsrechnung her auf, und dann fällt die Interpretation von selbst ab.
Lineare Regression zur Klassifikation
Wenn wir an Regression denken, dann oft an eine Regressionsgerade in einem --Plot, bei dem auf der -Achse die unabhängige Variable (der Regressor) und auf der -Achse die abhängige Variable (der Regressand) aufgetragen ist. Bei der Klassifikation ist der Regressand die Klasse, .
Schauen wir uns das Schritt für Schritt an, für einen eindimensionalen Regressor mit zwei Klassen, deren -Werte sich überlappen:
Im eindimensionalen Plot liegen alle Punkte der Klasse 0 auf der Höhe und alle Punkte der Klasse 1 auf .
Die lineare Regression fittet eine Gerade durch diese Punktwolke. Die Gerade nimmt Werte in ganz an, auch weit außerhalb von .
Harte Klassifikation: Wir entscheiden für Klasse 1, wenn . Die Entscheidungsgrenze ist der Punkt mit ; die vorhergesagte Klasse als Funktion von ist eine Sprungfunktion.
Für einen zweidimensionalen Regressor wird aus der Geraden eine Regressionshyperebene über der -Ebene, und die Entscheidungsgrenze ist eine Gerade in der -Ebene – genau wie beim Perzeptron.
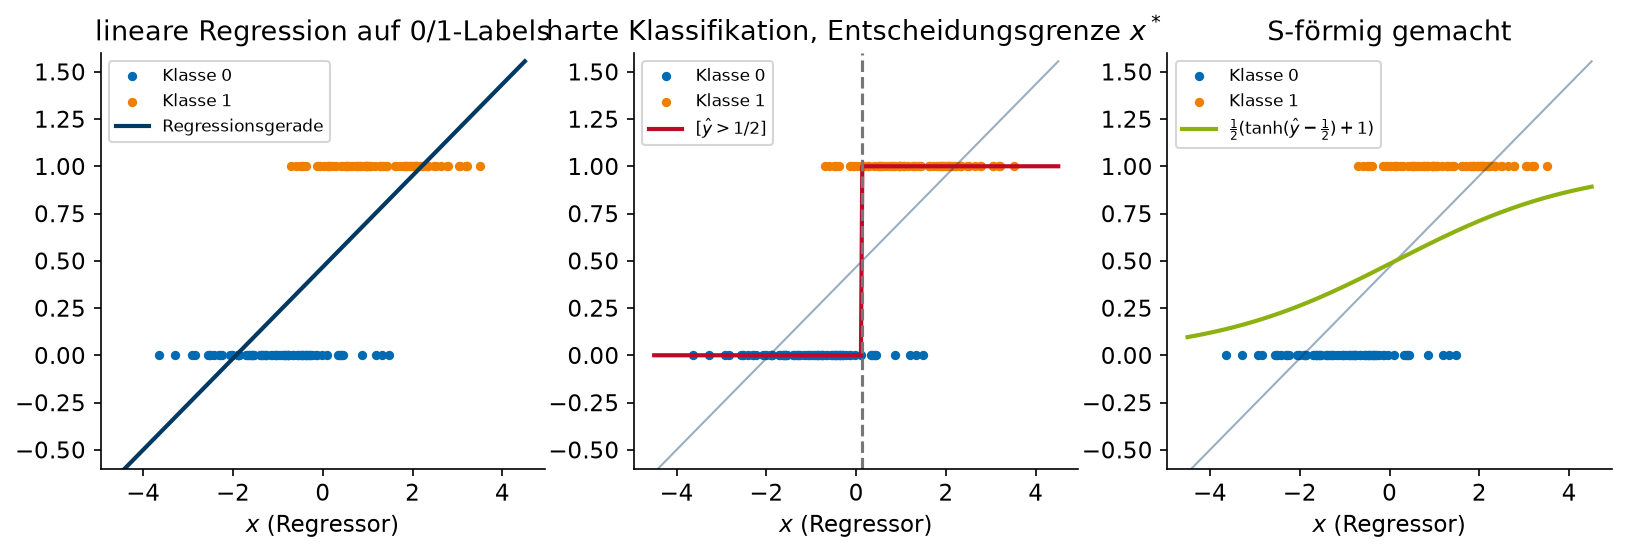
Lineare Regression zur Klassifikation, eindimensionaler Regressor: Regressionsgerade durch die 0/1-Daten, harte Klassifikation mit Entscheidungsgrenze , und die -Variante.
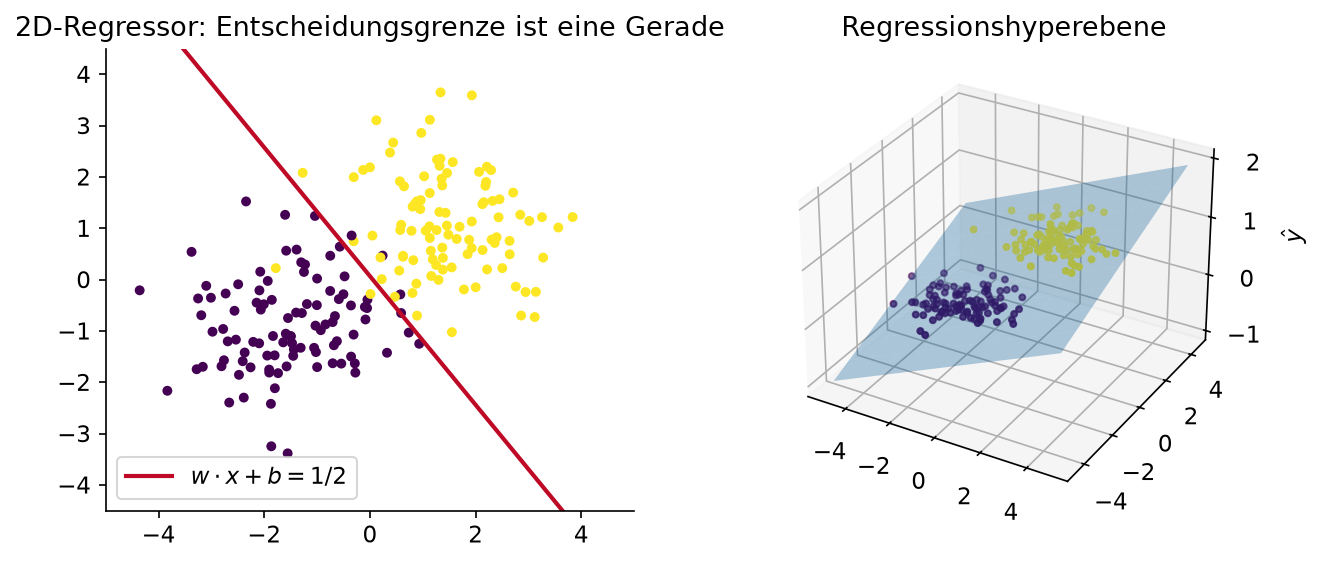
Zweidimensionaler Regressor: Die Entscheidungsgrenze ist eine Gerade, die Regressionsfunktion eine Ebene.
S-Förmigkeit herstellen
Die Sprungfunktion ist unbefriedigend: Sie ist nicht differenzierbar, und sie verrät nicht, wie sicher die Entscheidung ist. Anstelle von könnte man verwenden; liegt zwischen -1 und +1. Um zwischen 0 und 1 zu landen, kann man z.B.
nutzen. Das liefert eine S-förmige Kurve, die glatt von 0 nach 1 übergeht. Aber: Die Interpretation einer Zahl zwischen 0 und 1 als Wahrscheinlichkeit ist damit noch unklar. Genau das klären die nächsten Abschnitte dieses Kapitels, über Odds und Logit.
Wahrscheinlichkeiten und Chancen (Odds)
Chancen für ein Bernoulli-Experiment
Angenommen, wir haben ein Bernoulli-Experiment (Münzwurf) mit Parameter – zur Vereinfachung mit und . Die Wahrscheinlichkeit (probability) für Erfolg ist . Die Chancen (odds) für Erfolg sind .
Beispiel: Einen Standardwürfel (D6) rollen und gucken, ob es eine 6 ist. Dann ist die Wahrscheinlichkeit, und sind die Chancen für eine 6; sind die Chancen für eine Nicht-6. Als Formel:
Allgemein rechnet man von Wahrscheinlichkeiten zu Odds und zurück über
Die Skala für Odds
Wahrscheinlichkeiten liegen immer in . Wie sieht die Skala für Odds aus?
Wenn , so ist , also .
Wenn , so ist , also . Damit ist .
Wenn , so ist , also . Damit ist .
Die Fälle und sind symmetrisch, d.h. Erfolg und Misserfolg sind äquivalent – aber ist nicht symmetrisch: ist beschränkt, ist unbeschränkt. Die Odds für eine 6 sind , die Odds für eine Nicht-6 sind 5.
Beachte: Logarithmieren rettet die Symmetrie. Es ist
und damit . Die Werte liegen in .
Logistic Unit
Schon mal irgendwo gesehen? Im Data-Science-Skript haben wir den Informationsgehalt (die Überraschung) eines Ereignisses mit Wahrscheinlichkeit als definiert und die Entropie als erwartete Überraschung (Informationsgehalt, Entropie). Der Logarithmus steht dort aus einem Grund, der uns noch oft nützen wird: Für unabhängige Ereignisse multiplizieren sich die Wahrscheinlichkeiten, und macht daraus eine Summe. Zwei Überraschungen addieren sich. Ein fairer Münzwurf ist 1 bit Überraschung, eine 6 beim Würfeln bit, beides zusammen bit.
Für das Bernoulli-Experiment ist die Entropie
und ihre Ableitung nach ist
(im DS-Skript: Die binäre Entropiefunktion, dort mit und kleinem ). Interpretation: Bei Erhöhen von ist die Abnahme an Informationsgewinn durch gegeben. Entropie misst man in bit () oder nat (), die Ableitung in logit. Zum Beispiel ist .
Logistische Sigmoidfunktion
Allgemeine S-Förmigkeit
Sigma S, Sigmoid S-förmig.
ist der Maximalwert (die obere Asymptote), die Steilheit, die Position des Wendepunkts. Bei übernimmt die Rolle von , siehe Kapitel „Neuron und Perzeptron“: Die Länge von bestimmt, wie steil die Wahrscheinlichkeit mit dem Abstand zur Entscheidungsgrenze wächst. Das Standardsigmoid steigt monoton von 0 (für ) nach 1 (für ) und hat bei den Wert .
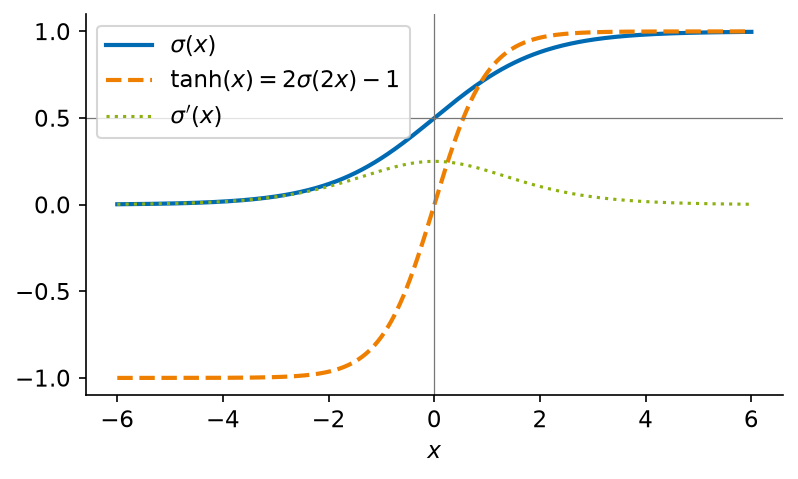
Das Standardsigmoid , der Tangens hyperbolicus als umskaliertes Sigmoid, und die Ableitung mit Maximum bei 0.
Symmetrie
Es gilt
also : Der Graph ist punktsymmetrisch um .
Andere Sigmoidfunktionen: Tangens hyperbolicus
Die Parameter und sind Skalierungsfaktoren. Möchte man die Skala des Standardsigmoids von auf z.B. bringen, so nimmt man , und mit :
Der Tangens hyperbolicus ist also nur ein umskaliertes Standardsigmoid, .
Ableitung
Wir benötigen später die Ableitung der Sigmoidfunktion. Eventuell bekannt ist . Ähnlich gilt
Der Beweis mit der Quotientenregel ist eine lohnende Übung. Bemerkenswert daran: Die Ableitung lässt sich aus dem Funktionswert berechnen, ohne noch einmal auszuwerten – das ist beim Training praktisch.
Sigmoid und Logit
Wir haben zwei Funktionen:
Also lassen sich beide Verkettungen bilden, und . Was haben die Funktionen miteinander zu tun?
Für ist
Für ist – erst mit erweitern, dann anwenden und nutzen –
Wir haben gesehen: und sind Inverse zueinander,
Darum nennt man als Inverse von auch expit.
Wie interpretieren wir das?
Gegeben einen Wert gibt einen Wert , sodass . Jeder Wert lässt sich also als Logit auffassen – als logarithmierte Chance –, und gibt die Wahrscheinlichkeit des Bernoulli-Experiments an, zu der der Logit-Wert ist. Das ist die Interpretation, die uns im ersten Abschnitt gefehlt hat: Eine Zahl zwischen 0 und 1, die aus kommt, ist eine Wahrscheinlichkeit, wenn die Eingabe ein Logit war.
Logistische Regression
Alle Zutaten sind bereit, jetzt wird gekocht. Die lineare Regression spuckt -Werte aus, die in ganz liegen. Wenn und zu den zwei Klassen korrespondieren, so fassen wir als Logit auf, und die Werte geben die Wahrscheinlichkeit an, in Klasse 1 zu liegen. Wenn , so entscheiden wir für Klasse 1 – und weil monoton mit ist, ist das dasselbe wie .
In Scikit-Learn wird in der logistischen Regression unterschieden zwischen predict und predict_proba. Den Wert selbst liefert decision_function, und damit ist
predict_proba gibt also eine Spalte pro Klasse zurück, in der Reihenfolge von classes_: bei Labels zuerst , dann . Die Wahrscheinlichkeit für Klasse 1 steht in der zweiten Spalte. Beim Softmax weiter unten begegnet uns dieselbe Form für Klassen.
Lineare Regression in PyTorch
In PyTorch macht man eine lineare Regression so:
import torch
import torch.nn as nn

class LinearRegression(nn.Module):
    def __init__(self, input_dim, output_dim):
        super().__init__()
        self.linear = nn.Linear(input_dim, output_dim)

    def forward(self, x):
        return self.linear(x)
Ein Modell ist eine Unterklasse von nn.Module; im Konstruktor werden die Bausteine mit Parametern angelegt (hier eine einzige lineare Schicht nn.Linear, das ist ), und forward beschreibt die Inferenz. Das Training:
import numpy as np

x = np.linspace(0, 10, 50)                      # irgendein eindimensionaler Datensatz
y = 2.5 * x + 1.0 + np.random.normal(0, 1, 50)  # verrauschte Gerade

model = LinearRegression(1, 1)
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

inputs = torch.from_numpy(x.reshape(-1, 1).astype("float32"))
labels = torch.from_numpy(y.reshape(-1, 1).astype("float32"))

number_of_epochs = 100
losses = np.zeros(number_of_epochs, dtype="float32")

for epoch in range(number_of_epochs):
    optimizer.zero_grad()
    outputs = model(inputs)
    loss = criterion(outputs, labels)
    loss.backward()
    optimizer.step()
    losses[epoch] = loss.item()

y_pred = model(inputs).detach().numpy()
Die fünf Zeilen in der Schleife sind die Trainingsschleife von PyTorch, die uns in allen weiteren Kapiteln begleitet: Gradienten auf null setzen, Vorwärtsrechnung, Loss berechnen, Gradienten rückwärts berechnen (backward), Parameter anpassen (step). Was criterion (die Loss-Funktion, hier der mittlere quadratische Fehler MSE) und optimizer (hier stochastischer Gradientenabstieg SGD mit Lernrate ) genau tun, klären die nächsten beiden Kapitel.
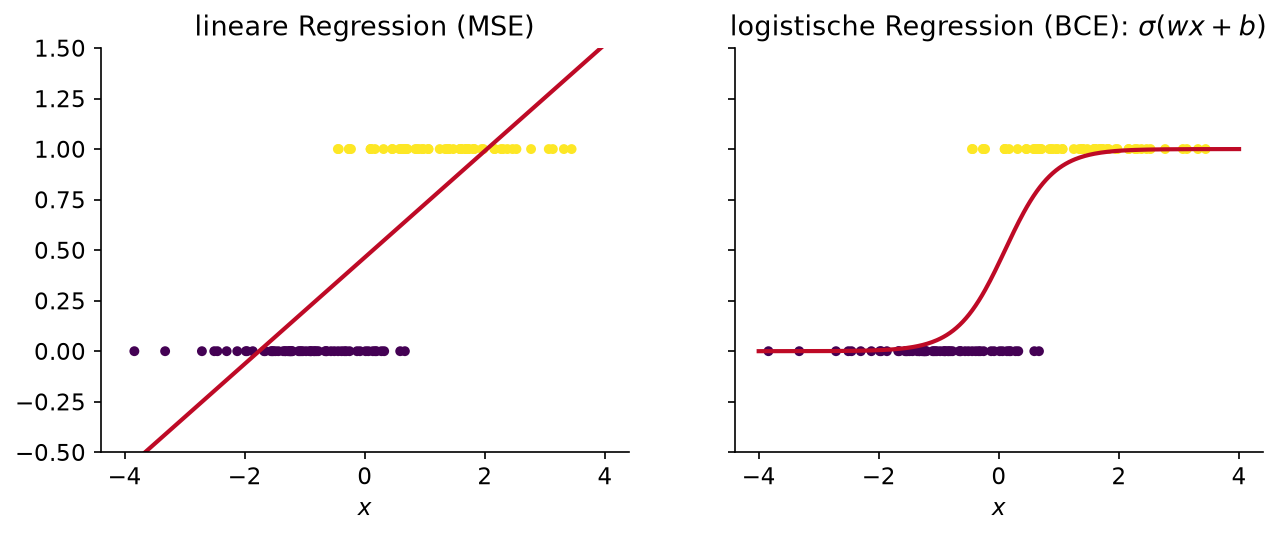
Dieselben 0/1-Daten, einmal mit linearer Regression (MSE-Loss) und einmal mit logistischer Regression (BCE-Loss) gefittet.
Logistische Regression in PyTorch
Für die logistische Regression ändern sich genau zwei Zeilen: Die Aktivierungsfunktion in forward
class LogisticRegression(nn.Module):
    def __init__(self, input_dim, output_dim):
        super().__init__()
        self.linear = nn.Linear(input_dim, output_dim)

    def forward(self, x):
        return torch.sigmoid(self.linear(x))  # <---
und die Loss-Funktion:
model = LogisticRegression(1, 1)
criterion = nn.BCELoss()  # <---
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Der Rest der Trainingsschleife bleibt identisch. BCELoss ist die binäre Kreuzentropie: die erwartete Überraschung, wenn man mit den vorhergesagten Wahrscheinlichkeiten rechnet, die Wahrheit aber ist. Sie ist bis auf eine Konstante die Kullback-Leibler-Divergenz aus dem DS-Skript (dort geschrieben); den genauen Zusammenhang und woher diese Loss-Funktion kommt, klärt das nächste Kapitel.
Weg von der 2-Klassen-Gesellschaft: Softmax
Von Bernoulli zu Multinoulli
Von binomial (2 Klassen) zu multinomial ( Klassen): Anstelle eines einzelnen -Werts der linearen Regression, der uns mit die Wahrscheinlichkeit für Klasse 1 angibt, benötigen wir nun einen Vektor der Länge , der sich auf 1 aufsummiert. Für erwarten wir den Vektor .
Wenn wir die Klasse one-hot kodieren, also Vektoren der Länge mit einer 1 an Stelle und sonst Nullen als Labels verwenden, dann liefert multinomiale lineare Regression – eine Matrix statt eines Vektors – Vorhersagevektoren . Die Entscheidung für Klasse fällt, wenn der Eintrag des Vektors an Index am größten ist, . Gesucht ist, analog zu , ein „soft argmax“.
Man darf sich das zweistufig vorstellen: Im ersten Schritt wird der Vektor komponentenweise exponenziert (alle Einträge werden positiv, und die Reihenfolge bleibt erhalten), im zweiten Schritt wird der Vektor normiert, sodass die Summe 1 ist. Für den Fall mit können wir leicht einsehen, dass
Softmax verallgemeinert also tatsächlich das Sigmoid, wobei nur die Differenz der Logits zählt. Obacht beim Vergleich mit : In der Softmax-Formel steht kein Minus im Exponenten. Das Minus in entsteht erst beim Kürzen für , wie eben gerechnet. Die Probe, dass wirklich eine Wahrscheinlichkeitsverteilung ist: Alle Einträge sind positiv, und die Summe ist .
Übung
Zeigen Sie . Tipp: Erweitern Sie mit .
Zeigen Sie . Tipp: Quotientenregel, dann mit multiplizieren und so lange umformen, bis die Definition von dasteht. Mit Teil 1 ist das dasselbe wie die aus der Literatur bekannte Form .
Wie groß ist ? Und wie groß sind die Odds bei ?
Antwortprobe: Die Odds sind 1. Die andere Zahl ist nach Teil 2 ein Produkt aus zwei gleichen Faktoren, also eine Quadratzahl; steht bei Ihnen , haben Sie statt ausgerechnet.