Im letzten Kapitel blieb die Frage offen, in welche Richtung man von der bisher besten Schätzung aus gehen soll, damit die Loss-Funktion kleiner wird. Die Antwort ist der Gradient, und um ihn für verkettete Funktionen auszurechnen, brauchen wir zuerst die Kettenregel.
Kurze Erinnerung an die Kettenregel
Für das Training werden wir Ableitungen von verketteten Funktionen brauchen, deshalb die Kettenregel in der Form, die wir benötigen: für Funktionen zwischen Vektorräumen.
Für eine Funktion an einem Punkt ist die Ableitung – eine -Matrix, die Jacobi-Matrix – die beste lineare Approximation, also für nah bei :
Gegeben eine weitere Funktion , ebenso
Im Spezialfall , setzen wir ein:
Damit ist die beste lineare Approximation von bei . In anderer Notation der gleiche Sachverhalt:
Die Ableitung einer Verkettung ist das Matrixprodukt der Ableitungen, ausgewertet an den richtigen Stellen. Das ist bereits die halbe Backpropagation.
Summe über alle Pfade. Die Matrixform versteckt einen Fall, der beim Rechnen von Hand oft schiefgeht: Wenn eine Variable auf mehreren Wegen in das Ergebnis eingeht, addieren sich die Beiträge. Für mit und ist
Kleinstes Beispiel: und , also . Wer nur einem Pfad folgt, erhält ; richtig ist . In einem Netz geht jedes Gewicht der ersten Schicht über alle Neuronen der zweiten Schicht in den Loss ein. Backpropagation ist im Kern die Buchhaltung dieser Summe, und die Matrixmultiplikation erledigt sie automatisch: Ein Matrixprodukt ist eine Summe über Zwischenindizes.
Numerische Probe. Ableitungen kann man nachprüfen, ohne sie zu kennen: Für kleines ist
Beispiel: , also und . Nachrechnen: , , Differenzenquotient . Diese Probe (gradient check) ist der wichtigste Handgriff, wenn eine von Hand hergeleitete Ableitung oder ein selbst geschriebenes backward nicht stimmen will. PyTorch hat sie eingebaut: torch.autograd.gradcheck.
Gradienten
Wir stellen uns für den Moment vor, dass ist (also die Daten zwei Features haben). Wir stellen uns die -Ebene vor und darauf ein -Gebirge. An jedem Punkt die Frage: Wohin sollen wir gehen, wenn wir runter wollen? Antwort: In die Richtung, wo am schnellsten kleiner wird, also „nach unten“ – das heißt entlang des negativen Gradienten .
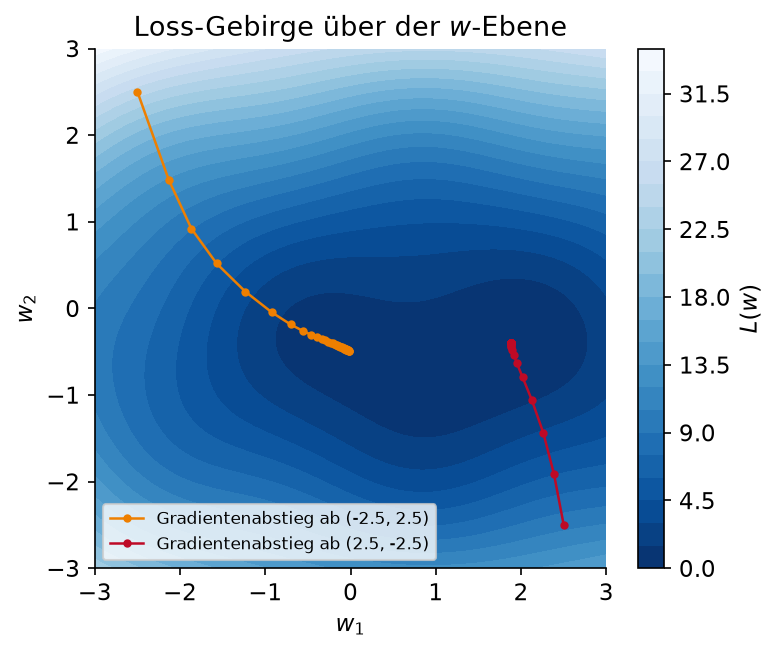
Ein (erfundenes) Loss-Gebirge über der -Ebene mit zwei Gradientenabstiegspfaden von verschiedenen Startpunkten. Beide landen im selben Tal – das ist nicht immer so.
Gradienten konkret
Betrachten wir den MSE für eine lineare Regression, mit der Notation für Feature von Datenpunkt aus dem Kapitel „Was ist Deep Learning?“:
Halte zunächst die Komponente fest und variiere . Das gibt eine Funktion in einer Variablen, , und ihre Ableitung gibt die Änderung von abhängig von an, also die Änderung in Richtung der ersten Koordinate der -Ebene: „Wenn ich einen (infinitesimalen) Schritt nach Osten gehe, wie stark ändert sich dann?“ Danach festhalten und variieren: ein Schritt nach Norden.
Diese beiden Ableitungen heißen besser partielle Ableitungen und , und der Gradient ist der Vektor aus beiden:
Nicht verwechseln: die Ableitung (eine Funktion, die jedem einen Vektor zuordnet) und , der Gradientenvektor an einem Punkt .
Richtungsableitung. Die Änderung in Richtung ist . Die Änderung in Richtung eines beliebigen Einheitsvektors ist
In welche Richtung ist die Änderung maximal? Das Skalarprodukt ist mit dem Winkel zwischen und dem Gradienten, und der Kosinus ist maximal 1, wenn in Richtung zeigt, und minimal -1 in der Gegenrichtung. Der Gradient zeigt bergauf, der negative Gradient bergab.
Vertiefung: dasselbe mit Cauchy-Schwarz
Ohne Winkel: Nach der Cauchy-Schwarz-Ungleichung ist mit Gleichheit genau dann, wenn ein nichtnegatives Vielfaches von ist. Für Einheitsvektoren ist die rechte Seite , und sie wird genau in Richtung erreicht. Das Argument funktioniert in jeder Dimension, auch dort, wo man sich keinen Winkel mehr vorstellen kann.
Endlich ausrechnen. Mit der Kettenregel:
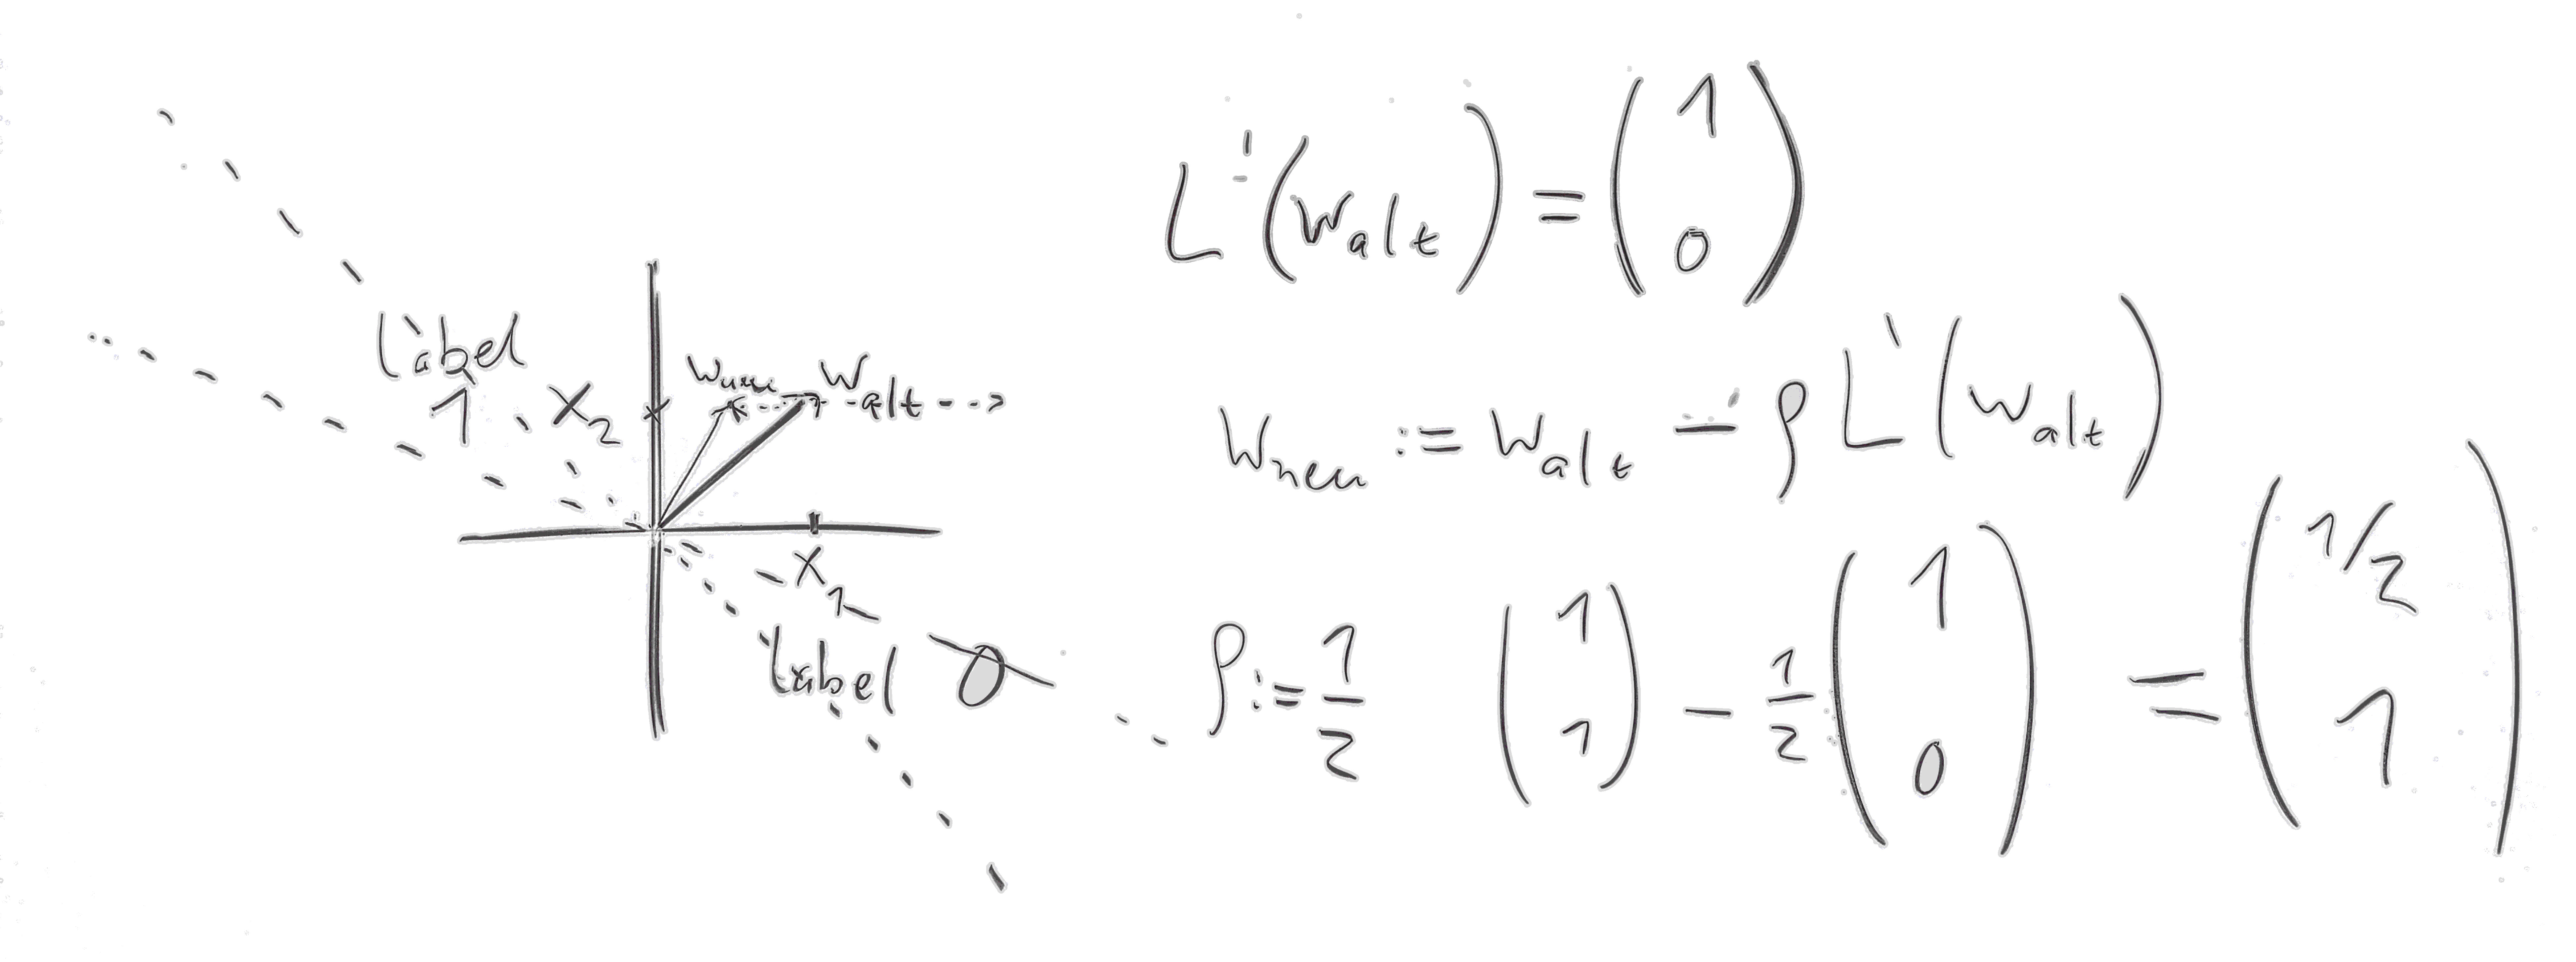
Tafelbild zum Gradientenschritt von Hand (WiSe 2025/26).
Der Algorithmus
Damit haben wir die sehr clevere Variante der approximativen Minimierung:
Sehr clever ein auswählen, in der Nähe der bisher besten Schätzung:
ausrechnen, vergleichen mit dem bisher niedrigsten Wert,
Größer? Pech gehabt, weitermachen (ggf. mit kleinerem ). Kleiner? Besseres gefunden!
Jetzt ggf. aufhören, wenn gut genug ist.
Das ist der Gradientenabstieg, und ist die Lernrate – dieselbe, die wir beim Perzeptron schon hatten. Zu klein, und man braucht ewig; zu groß, und man springt über das Tal hinweg.
Wie groß „zu groß“ ist, hängt von den Daten ab, und zwar von jedem Feature einzeln. Für den MSE ist , also proportional zu den Werten von Feature . Hat Feature 1 Werte um 1 und Feature 2 Werte um 1000 (Körpergröße in Metern, Einkommen in Euro), so ist die zweite Gradientenkomponente etwa tausendmal größer als die erste, und die Krümmung des Loss-Gebirges in -Richtung ist eine Million mal größer: Das Tal ist eine lange, schmale Schlucht. Eine Lernrate, die in -Richtung vernünftig vorankommt, springt in -Richtung über die Schlucht hinaus; eine, die dort stabil ist, kriecht in -Richtung.
Der einfachste Ausweg ist, alle Features vorher auf Mittelwert 0 und Standardabweichung 1 zu bringen (Standardisierung, sklearn.preprocessing.StandardScaler, und beim Testset mit den Werten aus dem Trainingsset skalieren). Dass dieselbe Idee auch innerhalb eines Netzes hilft (Batch Normalization, Layer Normalization) und dass Optimierer wie Adam die Lernrate pro Parameter anpassen, sehen wir in späteren Kapiteln; der Grund ist immer dieser.
Wie so ein Loss-Gebirge für ein echtes neuronales Netz aussieht, zeigen z.B. Li, Xu, Taylor, Studer und Goldstein, Visualizing the loss landscape of neural nets (arXiv:1712.09913, 2017). Die Landschaften sind nicht konvex, es gibt viele lokale Minima, Sattelpunkte und Plateaus – und trotzdem funktioniert Gradientenabstieg erstaunlich gut.
Zurück zum Perzeptron
Die neue Perspektive erklärt auch die Perzeptronregel. Der „harte“ Perceptron Loss hat ein Problem: Ableitung?!? Die Funktion ist stückweise konstant, der Gradient ist fast überall 0. Besser ist der „weiche“ Perceptron Loss ohne das :
Ein Summand ist 0, wenn korrekt klassifiziert ist (), und sonst , also proportional dazu, wie weit auf der falschen Seite liegt. Die (schwache) Ableitung ist
die Summe über die falsch klassifizierten Samples. Die allgemeine Update-Regel liefert für ein einzelnes , also :
Das ist exakt die Perzeptronregel. Rosenblatt hat also, ohne es so zu nennen, stochastischen Gradientenabstieg auf dem Perceptron Loss gemacht.
Und zurück zur logistischen Regression
Für die BCE lohnt sich dieselbe Rechnung, denn sie hat eine Pointe. Für ein einzelnes Sample mit Logit und ist
Mit und der Kettenregel:
Alle Logarithmen und Sigmoide heben sich gegenseitig weg; übrig bleibt der Vorhersagefehler. Mit ist der Gradient , und die Update-Regel lautet
Das ist buchstäblich die Perzeptronregel aus dem Kapitel „Das Perzeptron trainieren“, nur mit statt : Statt „falsch oder richtig“ zählt jetzt „um wie viel daneben“. Die Formel werden wir bei Backpropagation als Startwert der Rückwärtsrechnung wiedersehen; sie gilt genauso für Softmax mit Kreuzentropie.
Loss-Funktionen, die wir bisher gesehen haben
Für ein einzelnes Sample mit , aufgetragen gegen den Wert der Entscheidungsfunktion :
Perceptron Loss : null, sobald , davor linear.
Hinge Loss : null erst ab , verlangt also einen Sicherheitsabstand (Margin) – das ist der Loss der Support Vector Machine.
BCE Loss : glatt, wird nie exakt null, bestraft auch richtig klassifizierte Samples noch ein bisschen, wenn sie nahe an der Grenze liegen.
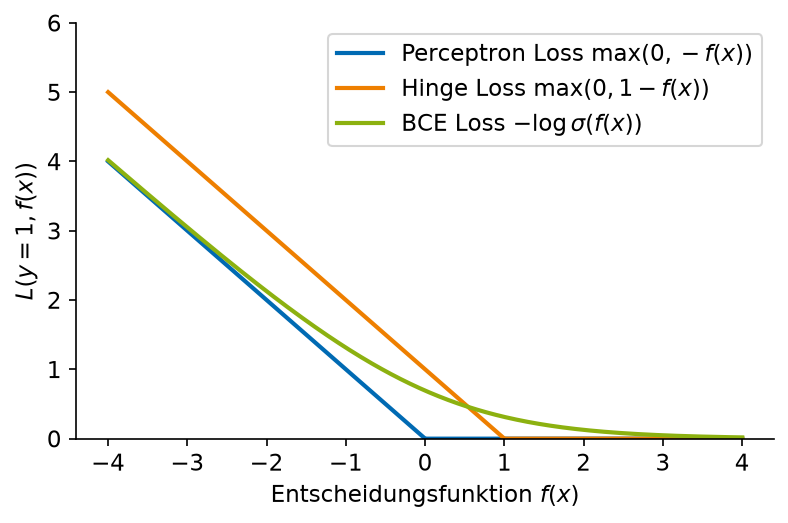
Drei Loss-Funktionen für ein Sample der Klasse in Abhängigkeit vom Wert der Entscheidungsfunktion .
Take-Home Message
Ein einzelnes Neuron besteht aus einer Aktivierungsfunktion und einem Gewichtsvektor (den Parametern). Inferenz:
Training, mit Hyperparameter , hängt von der Loss-Funktion ab:
Für binäre Klassifikation nimmt man und . Das ist logistische Regression. In echt kennt man die Landschaft nicht und muss die Lernrate ausprobieren.
Nicht-stochastischer Gradientenabstieg??
Gradientenabstieg ist der Oberbegriff und gleichzeitig die spezifische Bezeichnung für: den ganzen Datensatz einlesen, dabei die Loss-Funktion auswerten und den Gradienten bestimmen, damit die Gewichte anpassen, und erneut den ganzen Datensatz einlesen usw. (auch Batch Gradient Descent).
Stochastischer Gradientenabstieg (SGD) ist das Anpassen der Gewichte mit einer Schätzung des Gradienten aus einem Teildatensatz – meist ist ein einzelnes Sample gemeint. Das ist zufällig gewählt (die Anordnung der Daten wird als zufällig angenommen), daher stochastisch. Der geschätzte Gradient ist verrauscht, aber im Mittel korrekt, und man kommt viel häufiger zu einem Update.
Was „im Mittel korrekt“ genau heißt: Der Loss ist ein Stichprobenmittel, also eine Schätzung des Erwartungswerts über die erzeugende Verteilung aus dem Kapitel „Was ist Deep Learning?“. Das ist die Größe, die wir eigentlich klein haben wollen, denn sie misst den Fehler auf neuen Daten. Der Gradient eines Mini-Batches ist ebenfalls ein Stichprobenmittel; weil der Erwartungswert linear ist, ist sein Erwartungswert der Gradient des vollen Loss. Nach dem Gesetz der großen Zahlen (DS-Skript) liegt das Mittel über viele Batches nahe daran, auch wenn jeder einzelne Batch danebenliegt.
Wo steckt in diesem Verfahren überall Zufall? Im Startvektor, in den Daten, die wir als Stichprobe einer Verteilung modellieren, und in der Reihenfolge, in der die Samples verarbeitet werden. Deshalb liefern zwei Trainingsläufe mit denselben Daten verschiedene Gewichte, und ein Schritt lässt sich nicht sinnvoll rückgängig machen; man kann nur neu starten.
Der Kompromiss ist Mini-Batch SGD: Eine kleine, handhabbare Menge von Samples (die Batch Size, z.B. 32 oder 64) wird gemeinsam verarbeitet und damit der Gradient approximiert. Das ist, was in der Praxis fast immer gemeint ist, wenn jemand „SGD“ sagt – auch torch.optim.SGD aus dem Kapitel „Logistische Regression“ weiß nichts davon, wie viele Samples im Batch waren. Ein Durchlauf durch den gesamten Datensatz heißt Epoche.
Übung
Sei fest und .
Bestimmen Sie und mit der Kettenregel. Tipp: Äußere Funktion , innere . Die Ableitung von nach ist – mehr steckt nicht dahinter.
Werten Sie den Gradienten bei aus und führen Sie einen Schritt mit Lernrate aus.
Berechnen Sie vor und nach dem Schritt.
Antwortprobe: ist nach dem Schritt exakt 0 – bei und landet man genau im Minimum. Kommt etwas anderes heraus, fehlt meist der Faktor 2 aus der Kettenregel.